
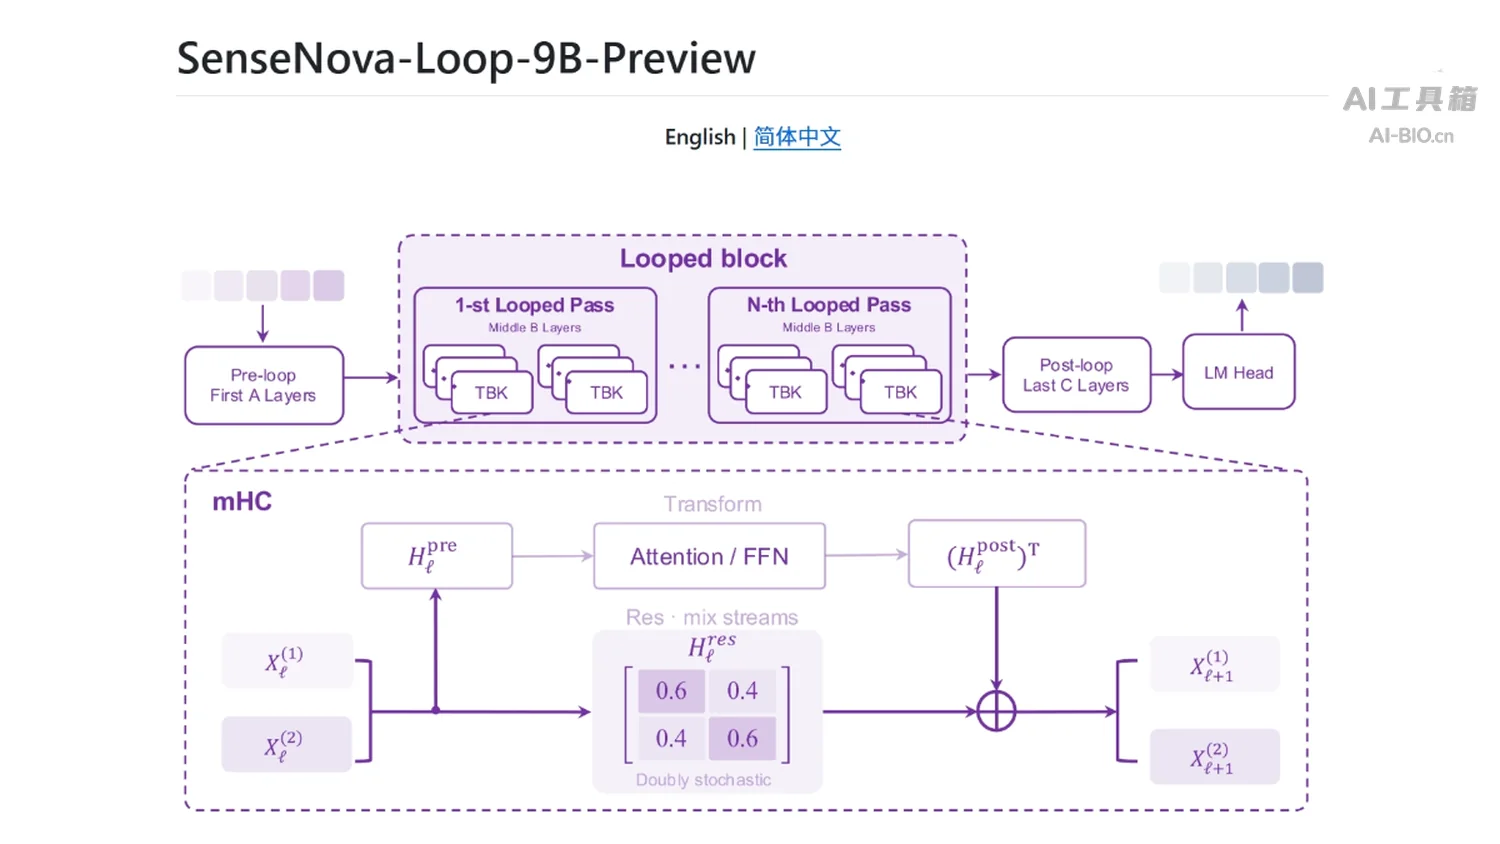
SenseNova Loop-9B-Preview 是商汤科技于 2026 年 10 月开源的多模态语言模型,面向长上下文与智能体工作流,接受文本与图像输入、输出文本。它把解码器第 4 至 27 层(从 0 开始编号)作为共享区块连续执行两遍,只用 32 层权重就完成 56 层计算,训练上下文最长 262,144 个 token,权重按 Apache-2.0 协议开放,适用于文档理解、代码生成与工具调用。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向长上下文与智能体工作流的多模态语言模型 |
| 出品方 | 商汤科技(SenseNova) |
| 发布时间 | 2026 年 10 月 30 日 |
| 开源协议 | Apache-2.0 |
| 参数规模 | 约 9B 总参数,约 14.6B 推理参数 |
| 架构 | 自回归多模态解码器,循环区块配双流 mHC |
| 输入输出 | 输入文本与图像,输出文本 |
| 训练上下文 | 最长 262,144 个 token |
| 权重发布 | Hugging Face sensenova/SenseNova-Loop-9B-Preview |
SenseNova Loop-9B-Preview 的核心能力
SenseNova Loop-9B-Preview 的重心在长材料与长任务上:32 层解码器里第 4 至 27 层连续执行两遍,每四层一组做三线性一全注意力,32 层权重完成 56 层计算,上下文到 262,144 个 token。以下四项是对照官方材料能核到的边界。
跨章节读完一份长材料
把 262,144 个 token 的材料一次装进上下文,跨章节检索、信息抽取与结论合并可放在同一次调用里,省掉切分与二次汇总;超出这个范围仍要分段处理。
长任务里连续调用外部工具
训练配方把文档、代码与工具轨迹混在一起,适合接入外部工具执行环境处理多步骤任务。工具调用、历史记录与中间状态由上层智能体框架管理,模型自身不承担持久化。
图像与文本混着读
输入接受文本与图像,视觉与文字进同一条序列,输出为文本。可用于报表截图取数、扫描件信息提取与设计稿字段整理,减少对独立 OCR 预处理的依赖。
在自有显卡上部署与继续微调
权重按 Apache-2.0 开放,模型卡给出 bfloat16 单卡加载示例但没给最低显存要求,服务化可走 LightLLM、SGLang 与 vLLM 三条路径。同类长文本推理加速可对照站内 RedKnot。
SenseNova Loop-9B-Preview 与同类多模态模型的对比
下表按出品方、开源情况、上下文长度等维度,把三款模型放在一起对照。
| 对比维度 | SenseNova Loop-9B-Preview | MiniCPM-V 4.7 | Muse Spark Open |
|---|---|---|---|
| 出品方 | 商汤科技 | 面壁智能与 OpenBMB | Meta |
| 开源情况 | Apache-2.0 | Apache-2.0 | 开放权重,Muse Model License |
| 参数规模 | 约 9B 总参数,约 14.6B 推理参数 | 35B-A3B 与 1B 两个版本 | 816B 总参数,42B 激活 |
| 上下文长度 | 最长 262,144 个 token | 262,144 个 token | 1,048,576 个 token |
| 输入模态 | 文本与图像 | 文本、图像与视频 | 文本、图像、视频与音频 |
| 主要用途 | 长文档理解、工具调用与智能体工作流 | 端侧图像与视频理解 | 复杂推理、编码与多模态智能体 |
| 部署形态 | 单卡示例,另有 LightLLM、SGLang、vLLM | 端侧手机与边缘设备 | 大规模 GPU 集群,NVFP4 约 700GB 显存 |
- 表格内数据来源:SenseNova Loop-9B-Preview 取官方模型卡与 GitHub 仓库,MiniCPM-V 4.7 与 Muse Spark Open 取站内规格页,未公开项按官方口径标注。
- 产品对比简述:上下文长度上 SenseNova Loop-9B-Preview 给到 262,144 个 token,参数规模仅约 9B;MiniCPM-V 4.7 参数规模分 35B-A3B 与 1B 两档,部署形态更偏端侧;Muse Spark Open 参数规模达 816B,部署形态明显更重,需要大规模 GPU 集群。
如果关心的是商汤同一系列里已经上线的多模态产品,站内的 SenseNova U1.5-8B-MoT 是可直接对照的一页。
SenseNova Loop-9B-Preview 的应用场景与适用人群
它擅长的是「一份长材料加一串工具调用」这类任务,单轮问答用不上这么深的执行路径:
- 长文档理解:Token 在 262,144 以内的材料一次装入上下文,跨章节比对与结论合并。
- 代码与工具调用:训练配方含工具轨迹,接入外部执行环境处理多步骤查询与结果校验。
- 图文混合任务:读图取数再落成文字结论,例如报表截图与设计稿的字段整理。
- 训练与微调:官方给出单机八卡的 TorchTitan 脚本。
适用人群:适合有长文档、长任务管线且要自建部署的团队,也适合做多模态智能体原型的工程组。只需端侧轻量识图的场景,可对照站内 ZDTaichu5.0-9B 这类更小的开源模型。
SenseNova Loop-9B-Preview 的使用方法
三条路径分属不同载体:本地推理、命令行服务、接口接入,取舍在显存与服务形态。
本地权重:用 Transformers 加载生成
- 按模型卡环境装依赖:Transformers 5.18.0、PyTorch 2.11.0(CUDA 13.0)、accelerate 与 safetensors。
- 在 Hugging Face 上取 SenseNova Loop-9B-Preview 权重,或直接用仓库 ID 让 transformers 拉取。
- 以 bfloat16 加载并开启
trust_remote_code,先做一次贪心解码确认输出正常。
命令行:用容器起一个推理服务
- 拉取 LightLLM 官方镜像,模型目录挂到
/model,四卡示例的--tp与 LOADWORKER 须一致。 - SGLang 拉 PR #47281 的分支、vLLM 拉 PR #64832 的分支,两个实现都还没进稳定版,升级别按主干走。
- 看启动日志里的显存占用与并行配置,再放真实请求。
接口:按 OpenAI 格式接进业务
- 用
/v1/chat/completions发一次请求,与本机推理逐字比对,确认两条链路一致。 - 改模型时克隆 OpenSenseNova/torchtitan,取
mhc2_loop2_titan.sh,把 MODEL_PATH 与 DATASET 指向自己的数据,单机八卡跑一轮。 - 循环层号、遍数与 mHC 路由都属执行配置,训练侧改动后要同步到推理侧。
SenseNova Loop-9B-Preview 的项目地址
- 官网:https://www.sensenova.cn/zh
- Hugging Face 权重:https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview
- GitHub 仓库:https://github.com/OpenSenseNova/SenseNova-Loop
SenseNova Loop-9B-Preview 的价格与开源情况
权重按 Apache-2.0 在 Hugging Face 开放,下载与自部署不向商汤付费,成本落在自有显卡上。协议允许商用与再分发,保留版权与许可声明即可。
商汤没有为这个 Preview 版本单独公布 API 单价,文中不写未经核实的数字。自建时的账分两段:推理侧的显存与卡数,微调侧的卡时。
想验证效果,先在单卡以 bfloat16 跑一次推理,再决定是否上多卡;显存与卡数随上下文长度、批量与推理框架变化,官方没给固定配置。
SenseNova Loop-9B-Preview 的常见问题
9B 参数为什么会有 14.6B 推理参数
两个口径不同。9B 是实际存储的权重规模,24 层循环区块两遍执行共享同一份参数;14.6B 是官方的推理参数口径,按单次前向 56 层计算折算,不存在另外 5.6B 独立权重。
循环执行两遍会增加显存占用吗
权重不增加,逐层计算次数增加。第二遍把第一遍的输出当作输入,不需要保留第一遍全部中间层激活;实际显存主要受 KV Cache、上下文长度、批量与注意力实现影响。
多模态支持到什么程度
输入支持文本与图像,输出是文本。模型卡未列视频与音频通道,视觉输入按图像处理,不按视频理解推断。
权重能商用吗
可以,Apache-2.0 允许商用与再分发,需保留许可与版权声明。商用前仍要评估训练数据来源的合规性。
和 SenseNova U1.5-8B-MoT 是什么关系
同属商汤多模态路线但取向不同:U1.5-8B-MoT 偏图文生成与编辑,Loop-9B-Preview 用循环解码把重心放在长上下文与智能体任务上。
相关文章

 浙公网安备33010202004812号