
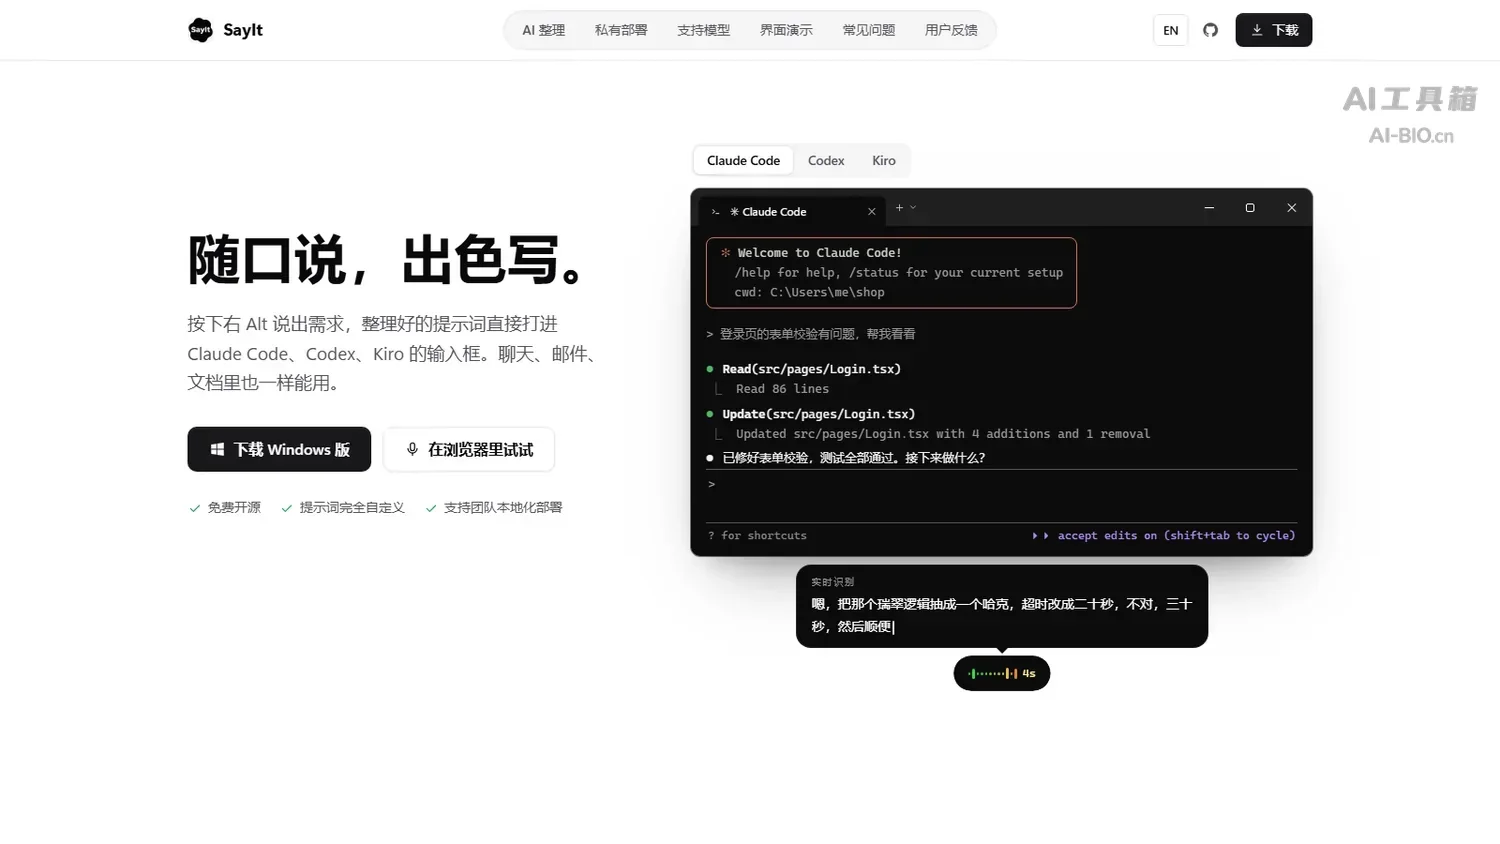
SayIt 是一款于 2026 年 5 月开源发布的Windows 语音输入工具,主要用于把口头表达实时转成整理过的文字并直接落到光标处,支持本地模型识别、云端接口与自托管服务器三条路径切换,适用于在编辑器里口述提示词、写提交信息与整理会议记录等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开源语音输入工具 |
| 出品方 | SayIt 开源项目 |
| 发布时间 | 2026 年 5 月 9 日 |
| 开源协议 | AGPL-3.0 |
| 客户端平台 | Windows |
| 触发方式 | 默认右 Alt 键 |
| 识别路径 | 本地模型、云端接口、自托管服务器 |
| 本地识别模型 | Qwen3-ASR、SenseVoice 等七款 GGUF 模型 |
| 服务端依赖 | Docker Compose、vLLM |
| 应用级规则 | Teams、VS Code、Cursor、微信等可分别绑定预设 |
SayIt 的核心能力
SayIt 没有把「语音转文字」当成一次性的转写任务,而是当成输入通道:说出来的东西先过一次语言模型整理,再以键入的方式落进当前光标。这个定位决定了三个差异点——识别放在哪里可选、清理规则颗粒度到单个应用、以及可以整队共用一台服务器。
三种识别路径按需要切换
本地模式在这一台电脑上完成识别,模型下载后断网也能用;云端接口模式把音频直接交给所选供应商,费用按该供应商结算;服务器模式是安装后的默认项,连的是官方试用服务器,有额度限制。三种模式在设置里直接切。云端接口模式走哪家供应商另算一层;站内的 Spark-ASR-2.0 提供的就是识别这一层的模型能力。
说出的话先被整理成书面文字
识别完成之后还有一次语言模型清理:口头的「嗯」「就是说」会被去掉,说到一半改口会按改口后的意思写,念错的专有名词按热词表纠正。清理强度由预设提示词决定,四套内置预设的完整提示词全部可见可改,也能从零新建并绑到快捷键上。
每个应用绑各自的预设
在 VS Code 里说需求和在微信里回消息,需要的文字风格并不一样。SayIt 允许按应用绑定规则:切到不同应用时自动套用对应预设,也能临时新增。这一步把「一个提示词通吃所有场景」的做法拆开了。
热词表管专有名词
项目名、框架名、同事姓名这类词是语音识别最容易错的地方。热词表把它们提前登记,识别阶段优先按登记形式输出,中英混写词不易被拆成谐音。对经常口述技术内容的用户,这一项比换更大的模型更直接。
自托管服务器与团队共用
服务端同样是开源的,用 Docker Compose 一组命令拉起,官方给出的参考配置是 NVIDIA A10G 24GB 显卡跑 Qwen3-ASR-1.7B 与 vLLM:30 秒音频约 0.8 秒、5 分钟约 3.0 秒。团队只填服务器地址就能用;服务端与识别模型都部署在内网时,音频与文本不出内网。
SayIt 与同类语音输入工具的对比
下表从识别跑在哪、提示词可改及团队共用等维度,对四款语音输入工具逐项对照。
| 对比维度 | SayIt | Chatterfly | 讯飞输入法 | Windows 语音输入 |
|---|---|---|---|---|
| 出品方 | SayIt 开源项目 | 腾讯 | 科大讯飞 | 微软 |
| 运行平台 | Windows 客户端 | Windows、macOS | Windows、macOS 与移动端 | Windows 11 内置 |
| 是否开源 | AGPL-3.0 | 闭源 | 闭源 | 随系统提供 |
| 识别跑在哪 | 本机、云接口或自托管服务器 | 公开资料未明确 | 云端为主 | 在线识别 |
| 提示词可改 | 四套预设全文可见可改 | 内置场景指令,完整编辑未明确 | 不支持 SayIt 式提示词编辑 | 无 AI 整理提示词 |
| 团队共用 | 自托管服务器,内网部署 | 公开资料未明确 | 按账号体系 | 不提供 |
| 计费结构 | 客户端免费,识别费用随模式自负 | 限时内测,收费方案未公开 | 基础功能免费,增值另计 | 随系统免费 |
- 表格内数据来源:SayIt 取自官方仓库与性能说明,Chatterfly、讯飞输入法与 Windows 语音输入仅登记公开资料可确认项,未披露处不填写;机房与留存策略以各家隐私条款为准。
- 产品对比简述:识别跑在哪上 SayIt 三条路径自选,讯飞输入法与 Windows 语音输入依赖厂商云端服务,Chatterfly 的识别架构公开资料未明确;提示词可改仅 SayIt 开放完整预设编辑;团队共用上仅 SayIt 提供自托管路径,讯飞输入法背靠账号体系。
如果更想先看腾讯这类大厂做的语音输入产品是什么形态,站内的 Chatterfly(腾讯推出的 AI 原生语音输入助手)可以对照着看。
SayIt 的应用场景与适用人群
说比打字快、但说出来的内容不能直接用时适用;偶尔输入一两句话,不值得为此配置:
- 口述提示词:对着 Claude Code、Codex、Kiro 这类终端或编辑器说需求,整理过的句子直接落进输入框。
- 写提交信息与工单:把中文口语说成规范的一条 commit message,或整理成工单正文。
- 会议与访谈记录:接自托管服务器在团队内共用,录音不上公网,事后检索历史记录。
适用人群:适合长期在 Windows 上写代码或写文档、每天输入量以千字计的人,也适合要给团队统一语音输入通道的技术负责人;主要在移动端输入、或只需要偶尔转写一段录音的用户,用现成的转写服务更省事。想先了解识别模型本身能到什么水平,站内的 MAI-Transcribe-2 与 Qwen-Audio-3.1 是两条可参照的路线。
SayIt 的使用方法
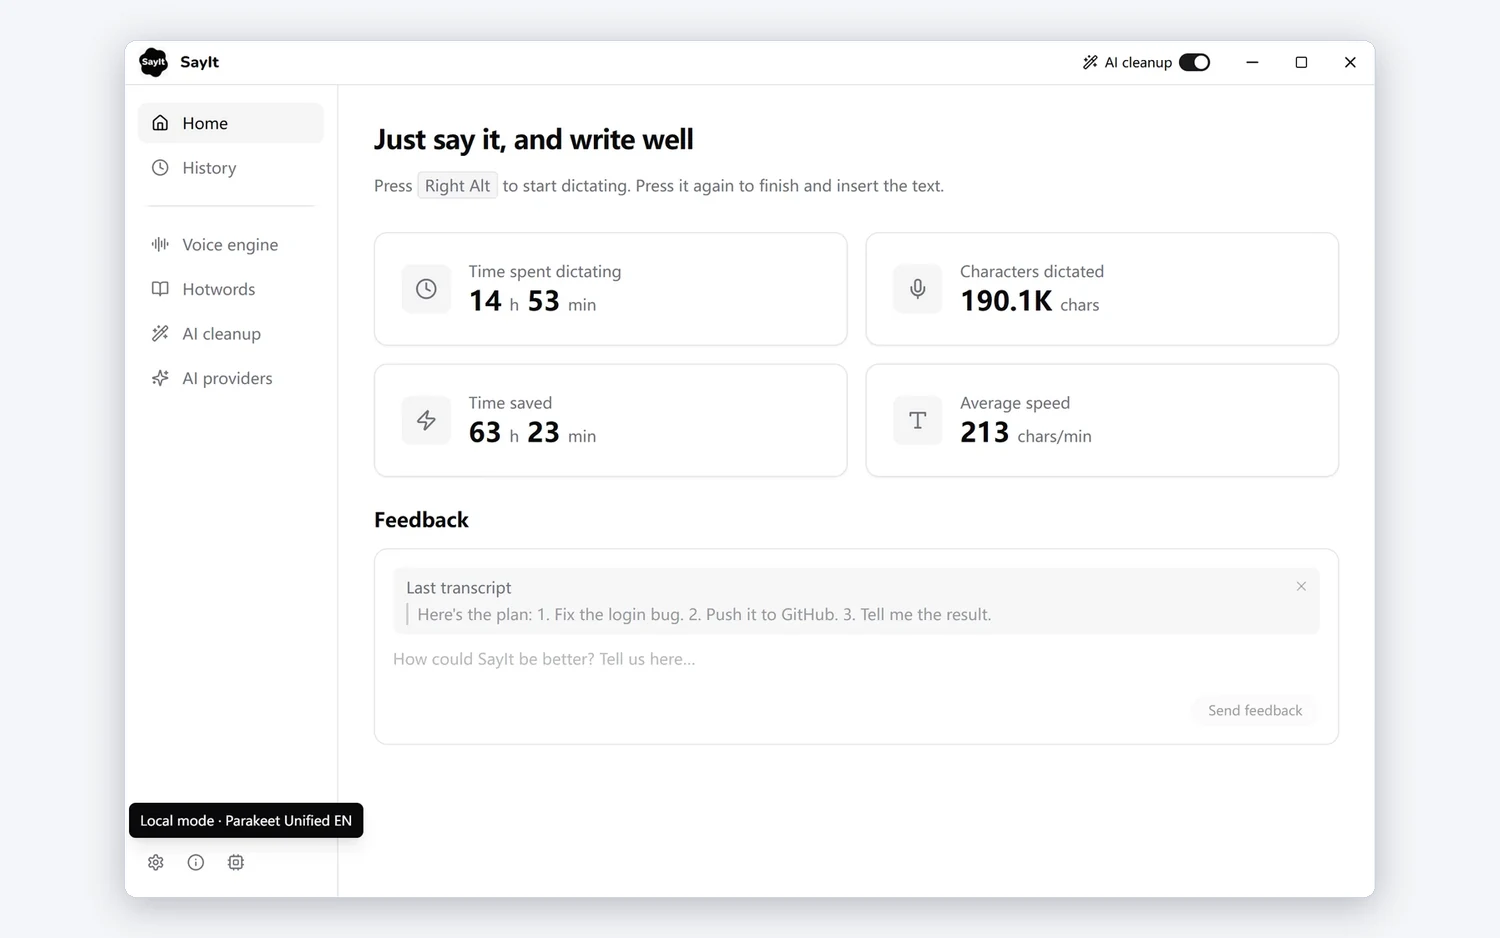
官方给了两条路径:Windows 客户端装完就能说,客户端里还能切本地、云端与服务器三种识别模式;或自己起一套服务器给团队共用。
Windows 客户端:装完按快捷键就能说
- 在 SayIt 官网 下载 Windows 安装包并完成安装,首次启动不需要填密钥,默认连公共试用服务器。
- 在任意输入框按下配置好的快捷键开始说,说完再按一次结束,整理后的文字自动插入光标处;按住说话另有独立快捷键。
- 日常使用建议切本地模式:在语音引擎里按硬件挑一个模型下载;七款 GGUF 模型里英文优先 Parakeet Unified EN,多语种看 Nemotron 3.5 ASR。
- 要云端精度就填自己的供应商密钥(豆包、Qwen、OpenAI、Gemini 等),录音直接发给该供应商,不经过 SayIt 服务器;试用服务有额度限制,用完需切到本地或自填密钥。
自建服务器:Docker Compose 给团队一套共用通道
- 克隆仓库后进入 server 目录,复制
config.example.yaml与.env两份样例文件。 - 执行
docker compose up -d --build拉起服务,按官方参考挂显卡与 Qwen3-ASR 模型,默认模型建议 16GB 以上显存。 - 把服务器地址发给同事,各自在客户端填同一个地址;并发上限与配额在服务端配置。
三点需留意:切到云端接口模式后录音会直接发给所选供应商,团队使用前应先确认这条数据流向;服务器模式的音频不落在服务端,但转写结果存在本地,换机器需自行迁移;多人共用一台服务器时,服务端配置由部署者统一维护,客户端的预设与热词各自管理。站内另有一份关于语音识别延迟的口径讨论:R2T2。
SayIt 的项目地址
- 产品官网:https://sayitapp.site/
- 项目仓库:https://github.com/crosswk/SayIt
SayIt 的价格方案
客户端本身不收费,支出取决于识别环节走哪条路径。
- 客户端:免费且开源,协议为 AGPL-3.0,个人与团队都可直接使用与修改
- 本地模式:只消耗本机算力,模型免费下载;文本清理接本机 Ollama 同样不产生额外费用
- 云端接口模式:按所选供应商的用量计费
- 服务器模式:自建时由自己承担机器成本,官方另提供一台带额度限制的试用服务器
团队规模较大时自建更划算:官方建议默认服务端模型使用 16GB 以上显存的 NVIDIA 显卡,实际并发能力取决于显卡、音频长度与服务器资源;服务端部署在内网时音频不出内网。
SayIt 的常见问题
只有 Windows 版吗
目前客户端只提供 Windows 版本,官网下载按钮也只列出 Windows;仓库里有服务端代码,但没有桌面端跨平台分支的公开说明。
本地模式的识别准不准
取决于所选模型。本地提供七款 GGUF 模型(Qwen3-ASR、SenseVoice、Fun-ASR、Nemotron、Parakeet 等);中文场景建议先试 Qwen3-ASR。
录音会被上传吗
看模式。本地模式下识别在本机完成,关闭 AI 整理时数据不出本机,开启 AI 整理则取决于所选语言模型位置——本机 Ollama 仍在本地处理,云端模型会把识别文本发给对应供应商;云端接口模式把音频交给供应商;服务器模式上传到所连服务器且不在服务端留存。
能不能给团队统一部署
可以。服务端开源自带 Docker Compose 配置,团队共用一台服务器,客户端只填地址,服务端可设并发上限与配额。
支持中英混说吗
内置预设含中文转英文一条,可把中文口述整理后翻译成英文;中英混说效果取决于所选识别模型,热词表可缓解专有名词写成谐音。
相关文章

 浙公网安备33010202004812号