
Nemotron 3.5 Transcribe 是英伟达于 2026 年 10 月推出的开放权重语音转录模型,用 34B 总参数、4.3B 激活的混合专家架构把转录、说话人归属、翻译与音频问答并入同一个模型,适用于会议纪要、多语种字幕与长录音归档等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 开放权重语音转录模型 |
| 出品方 | 英伟达(NVIDIA) |
| 发布时间 | 2026 年 10 月 28 日 |
| 参数规模 | 总 34B、激活 4.3B(含音频编码器;权重仓库名 30B-A4B) |
| 转录语言 | 40 种(含印地语、孟加拉语等多种印度语言) |
| 翻译能力 | 31 种非英语语言与英语双向互译 |
| 最长录音 | 1 小时 |
| 上下文窗口 | 65,536 tokens |
| 核心架构 | Mamba-2–Transformer 混合专家 + 并行专家编码器 |
| 许可协议 | OpenMDW-1.1(可商用) |
| BF16 部署 | 1× H100 80GB(vLLM 0.32.0 + NeMo Speech) |
| FP8 / NVFP4 | 按官方硬件兼容表选 GPU;NVFP4 面向 Blackwell 架构 |
| 精度版本 | BF16 / FP8 / NVFP4 |
Nemotron 3.5 Transcribe 的核心能力
参数表中四项直接影响选型:参数规模决定部署算力,转录语言决定覆盖范围,最长录音决定是否适合长音频,许可协议决定商用边界。
一个模型承接转录、说话人归属、翻译与音频问答
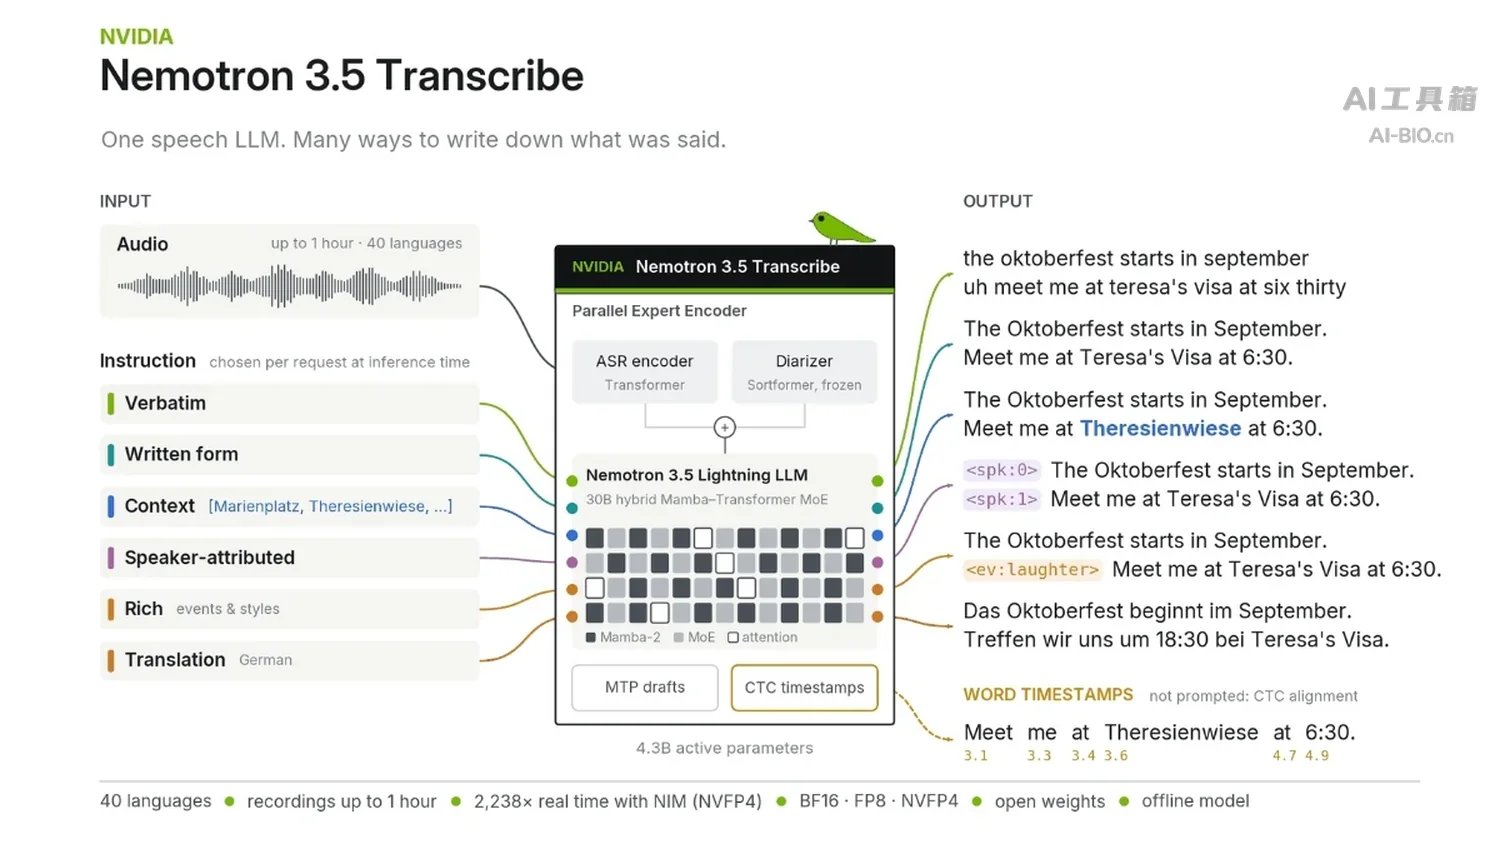
传统语音流水线通常要串联 ASR、说话人分离、机器翻译等多个模型,每一步都要对齐格式。Nemotron 3.5 Transcribe 用一条自然语言指令在同一模型内切换逐字或书面形式转录、说话人归属、语音翻译、语言识别与音频问答,例如对一段会议录音可同时要求「转录并标注每位说话人」。它属于语音增强语言模型(SALM),文本上下文还可提供术语与格式约定。其语言骨干承接自同厂 Nemotron 3 Super 一路的混合专家路线。
40 种语言转录,单次处理最长 1 小时录音
转录覆盖 40 种语言(含印地语、孟加拉语、泰米尔语等多种印度语言),其中 31 种非英语语言支持与英语双向互译;官方语言矩阵按 Leading、Production-ready、Supported 三档逐语言标注,中文普通话为 Supported 级,可能需微调。单次可处理最长 1 小时录音,上下文窗口 65,536 tokens,面向会议、访谈、播客等长音频,而非短句指令。官方明确这是离线模型,内部音频分块不等于实时流式服务,需要实时转写时应另选流式方案。另需注意:音频问答与指令理解官方仅在英语下评估,其他语言不保证可靠。
上下文转录与说话人级词时间戳
除逐字与书面形式外,模型支持上下文转录——给定一份预期实体清单即可降低专名错误,官方称在 ContextASR-Bench 上命名实体错误降低六倍;多说话人场景下输出说话人归属的逐词时间戳,由轻量 CTC 对齐器在解码后对齐生成,长录音与重度重叠场景同样可用。只关注目标说话人的场景可参考 Xiaomi-CocktailASR-1。
三档精度开放权重,自部署与托管两条路
权重以 BF16、FP8、NVFP4 三档精度开放,OpenMDW-1.1 许可,官方明确可用于商业与非商业用途。BF16 参考部署为 1× H100 80GB(vLLM 0.32.0 + NeMo Speech);FP8/NVFP4 按官方硬件兼容表选择 GPU,NVFP4 面向 Blackwell 架构,可部署到 DGX Spark、Jetson Thor、RTX 5090 等设备;也可直接调用 NVIDIA NIM 托管接口。吞吐加速可选原生 MTP 或 DFlash2 投机解码,两者二选一、不可叠加,DFlash2 模式下不支持 CTC 词级时间戳;官方最高吞吐 2,238 秒音频/秒来自 NIM 优化环境(RTX PRO 6000 Blackwell 96GB、NVFP4 加 DFlash2),发布当日的开源 vLLM 实现速度约为其一半,实际速度取决于 GPU、并发与推理配置。
Nemotron 3.5 Transcribe 与开放权重语音模型的对比
下表从参数规模、转录语言及评测成绩等维度,对 Nemotron 3.5 Transcribe 与 Qwen3-ASR-1.7B 逐项对照。
| 对比维度 | Nemotron 3.5 Transcribe | Qwen3-ASR-1.7B |
|---|---|---|
| 出品方 | 英伟达(NVIDIA) | 阿里通义(Qwen) |
| 参数规模 | 总 34B、激活 4.3B | 1.7B |
| 转录语言 | 40 种 | 30 种 + 22 种中文方言 |
| 英语 ASR(Open ASR Leaderboard 9 集) | 4.71% WER | 4.94% WER |
| 多语言 ASR(7 语) | 4.62% WER | 6.49% WER |
| 最长录音 | 1 小时 | 支持长音频(流式 + 离线) |
| 开放许可 | OpenMDW-1.1 | Apache-2.0 |
- 表格内数据来源:Nemotron 3.5 Transcribe 的 WER 取自英伟达官方 README「Best open-weight results」表,Qwen3-ASR-1.7B 取自阿里官方模型卡;评测采集于 2026-10-12,为厂商公布数据、非本站实测。
- 产品对比简述:参数规模上 Nemotron 3.5 Transcribe 用更大激活参数承接转录、说话人与翻译多任务,Qwen3-ASR-1.7B 以更小体积只做识别、部署更轻;转录语言上 Nemotron 3.5 Transcribe 按语言数计数,Qwen3-ASR-1.7B 按语言加方言计数,口径不同不能直接比大小。
如果更关注云端的语音转文本产品而非开放权重模型,可参考谷歌的 Gemini 3.5 Transcribe,它走的是托管 API 路线,与本文所述自部署模型属不同用法。
Nemotron 3.5 Transcribe 的应用场景与适用人群
官方把它的用途落到「把录音变成有用信息」,典型场景有四类:
- 会议纪要:转录多人会议录音并标注每位说话人,再追问会议中做出的决定。
- 多语种字幕:把访谈、播客等音频转成 40 种语言字幕,或与英语互译。
- 长录音归档:处理最长 1 小时的录音,输出带时间戳的逐字或书面形式文本。
- 专业领域转录:用提示词约定术语与格式,适配医疗、金融、客服等专业词汇;效果取决于术语清单质量,生产部署前需用业务录音实测。
适用人群:适合需要把会议、访谈、播客等录音转成结构化文本的团队与开发者,尤其是要说话人归属或多语种翻译、又希望权重可自部署的场景;只需逐字转写、不关心说话人的,用更小的模型更省算力。同类开放权重语音模型可参考 Qwen-Audio-3.1。
Nemotron 3.5 Transcribe 的使用方法
模型提供三条路径:下载权重自部署、走 NVIDIA NIM 托管 API、或在 HF Space 网页演示里免部署试跑,分别对应不同算力与接入需求。
自部署权重:Hugging Face 下载 + NeMo Speech 推理
- 下载权重:在 Hugging Face 模型库 选择 BF16、FP8 或 NVFP4 精度下载。
- 配环境:安装 vLLM
0.32.0与最新 NeMo Speech 主分支,设置VLLM_PLUGINS=nemo_speechlm。 - 起服务:按官方 Quick Start 在 1× H100 80GB 上启动推理,或用 NVFP4 量化版部署到本地 RTX/DGX Spark 设备。
- 用提示词控制:通过自然语言指令指定逐字或书面形式、说话人标注、翻译或问答输出。
NIM 托管 API:不装环境直接调用
- 打开 build.nvidia.com 的 Nemotron Transcribe NIM 模型页,按 NIM 接口约定传入音频与提示词。
- 用原生 MTP 或可选 DFlash2 投机解码提升吞吐,官方口径单卡最高 2,238 秒音频/秒。
在线体验:HF Space 免部署试跑
- 访问
nvidia-nemotron-transcribe.hf.space,进入卡拉 OK、播客或电影三类多语言演示。 - 上传一段音频,用提示词切换转录、翻译或问答,观察输出格式后再决定是否自部署。
注意:官方称该模型面向录音离线处理,非实时流式;NVFP4 版本与 NeMo-Speech.cpp、vLLM 部署方式在发布后陆续补齐,自部署前先确认目标精度与工具链版本。需要实时转写可参考站内的 Spark-ASR-2.0。
Nemotron 3.5 Transcribe 的项目地址
- Hugging Face 模型库(权重下载):https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- NVIDIA NIM 托管 API:https://build.nvidia.com/nvidia/nvidia-nemotron-3-5-transcribe-30b-a4b
- HF Space 在线演示:https://nvidia-nemotron-transcribe.hf.space
Nemotron 3.5 Transcribe 的价格与开源情况
模型权重免费开放:以 BF16、FP8、NVFP4 三档精度发布,OpenMDW-1.1 许可,官方明确可用于商业与非商业用途,下载与自部署本身不收费,成本只在部署所需的 GPU 算力——官方口径 1× H100 80GB。
托管接口按官方服务条款接入:开发者也可通过 NVIDIA NIM 托管 API 调用模型,可用性与收费规则以 NVIDIA 官方页面为准;开放权重自部署与 NIM 托管是两条独立路线,可混用。
Nemotron 3.5 Transcribe 的常见问题
它是开源的吗?
权重开放,但许可不是传统开源协议:官方以 OpenMDW-1.1 许可开放权重,明确可用于商业与非商业用途;与 Apache、MIT 等开源协议口径不同,商用前建议读一遍许可条款。再分发模型材料时需遵守许可条款,并留意所含第三方组件的独立授权。
支持哪些语言?
转录支持 40 种语言(含印地语、孟加拉语等多种印度语言),其中 31 种非英语语言支持与英语双向互译;官方矩阵按 Leading、Production-ready、Supported 三档标注,中文普通话为 Supported 级,可能需微调。音频问答与指令理解官方仅在英语下评估,其他语言不保证可靠。
能处理多长的录音?
最长 1 小时录音,上下文窗口 65,536 tokens;它面向录音离线处理,非实时流式,实时场景需另选流式模型。
部署要什么硬件?
BF16 参考配置 1× H100 80GB(vLLM 0.32.0 + NeMo Speech);FP8/NVFP4 按官方硬件兼容表选择,NVFP4 面向 Blackwell 架构,可部署到 DGX Spark、Jetson Thor、RTX 5090 等设备。
和 Qwen3-ASR 比怎么样?
英语与多语言 ASR 的词错误率都更低(4.71% 对 4.94%、4.62% 对 6.49%),但激活参数 4.3B 远大于 1.7B,部署算力也更高;选型看目标语言与可用 GPU。
相关文章


 浙公网安备33010202004812号