
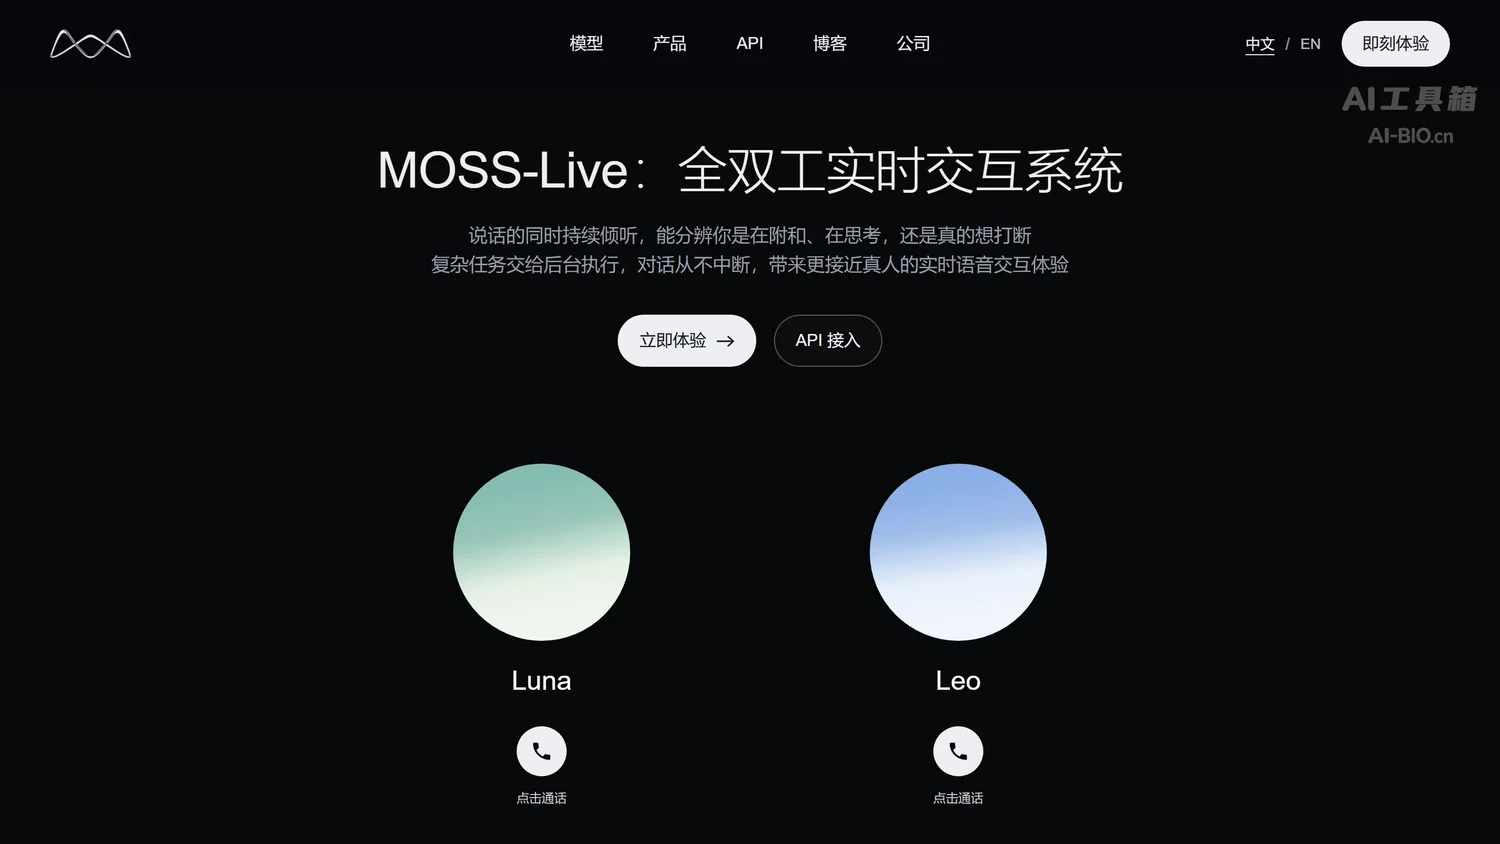
MOSS-Live 是模思智能于 2026 年 11 月推出的全双工实时交互系统,说话的同时持续接收并理解输入,按语义判断你是在附和、在思考还是真要打断;被打断后从断点续说,复杂任务交给后台模型异步执行,前台对话不中断,支持视频通话、屏幕共享与边听边译。适用于长对话客服、跨语言远程沟通、多人会议与座席辅助等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向实时语音与视频通话的全双工交互系统 |
| 出品方 | 模思智能(上海模思智能科技有限公司) |
| 发布时间 | 2026 年 11 月 3 日 |
| 模型状态 | Beta,模型 ID 为 moss-live-1.0 |
| 交互形态 | 全双工,说话过程中持续接收输入 |
| 判停机制 | 结合语义与当前对话状态区分附和、停顿与打断 |
| 架构 | 前后台协同,共享记忆、上下文与任务状态 |
| 感知与操作 | 语音、视频画面、屏幕共享 |
| 语言能力 | 边听边译,无需等整段说完 |
| 接入方式 | 官网产品页在线体验,或经 MOSS API 接入 |
MOSS-Live 的核心能力
MOSS-Live 的着力点不在音色或多语言,而在把「什么时候该说话」交给语义判断。以下五项能力对应它与其他实时语音模型的分野。
说话时仍在听,按语义判断何时接话
多数语音助手像对讲机,你说完它才说;MOSS-Live 更像一通电话,输出语音的同时持续接收并理解输入。「嗯」「对」被识别为附和,它继续讲;「等一下」被识别为打断,立即停下;你停下来思考,它等你把话说完。判据不只看静音了多久,还结合语义、说话意图与当前对话状态。同类全双工路线在字节的 SeedRealtime 上也能对照着看。
打断后从断点续说,只认已说出口的内容
被打断时,模型清楚自己实际说到了哪个字,之后的对话以此为准:从断点接续,也不会假设你听到了它还没说出口的部分。官方产品页的演示对话就是这一组:你问「刚才数到几了」,它答「数到 19,从 20 接着数」,而不是从头再来。
前台陪聊、后台办事,对话不中断
结构上前台交互模型始终在线,负责实时听与说;后台模型异步执行复杂推理与工具调用。两者通过记忆、上下文与任务状态管理协调,结果就绪后择机带回对话。因此调研、规划这类耗时任务不需要把对话挂起等待,前台可以继续聊别的事情。
几个人同时在场,也知道哪句话是对它说的
多人环境里,它按说话对象区分指令:哪一句是对它说的,旁人之间的闲聊它不插嘴。配合视频通话与屏幕共享,它能看见画面里的内容;按事先约定的规则,条件满足时主动出声,而不是等你再问一次。
边听边译,不等整段说完
翻译与倾听同步进行,你说到哪它译到哪,不必等一段话收尾再出译文。对跨语言会议与远程协作,这一条决定了译文能不能跟上讲话节奏。同类能力可对照站内的 Qwen3.8-LiveTranslate。
MOSS-Live 与同类实时语音模型的对比
下表从出品方、交互形态、上下文与时长、多模态感知等维度,对三款实时语音模型逐项对照。
| 对比维度 | MOSS-Live | GPT-Realtime-2 | Qwen-Audio-3.0-Realtime |
|---|---|---|---|
| 出品方 | 模思智能 | OpenAI | 阿里通义 |
| 交互形态 | 全双工语音加视频通话 | 端到端实时语音 | WebSocket 流式双工 |
| 上下文与时长 | 前后台共享任务状态,未公布上限 | 128K 上下文 | 50 轮 / 累计 300 秒音频上下文 |
| 多模态感知 | 语音、视频画面、屏幕共享 | 文本、图像、音频 | 语音、文本 |
| 工具调用 | 后台模型异步执行后带回对话 | 支持 | 支持 Function Calling |
| 接入与计费 | MOSS API,Beta 期限时免费 | 32 美元 / 百万音频输入 tokens | 按调用计费 |
- 表格内数据来源:MOSS-Live 一列取自模思智能官网产品页与 MOSS API 定价页,GPT-Realtime-2 一列取自站内该模型页的参数表与公开定价,Qwen-Audio-3.0-Realtime 一列取自站内该模型页的参数表。
- 产品对比简述:交互形态上 MOSS-Live 是全双工语音加视频通话,GPT-Realtime-2 走端到端实时语音;承载上 GPT-Realtime-2 给到 128K 上下文,MOSS-Live 靠前后台共享任务状态、未公布上下文上限。
同属 MOSS 系列的还有文生图方向的 MOSS-Image,走的是原生布局控制路线,和 MOSS-Live 的实时交互不是同一件事。
MOSS-Live 的应用场景与适用人群
对话会被打断、被打断后还要接着往下走时,全双工才有意义:
- 长对话客服:客户中途插话、追问与犹豫,模型按语义判断该停还是该等,不必回顾前面已经聊过的内容。
- 跨语言远程沟通:边听边译,译文跟着讲话节奏走,适合多语种会议与海外协作。
- 多人会议与访谈:分辨哪句话是对它说的,旁人闲聊不插嘴,会后还能调后台整理结论。
- 座席辅助与陪练:约定规则后主动出声提示,屏幕共享时能看见对方在看的内容。
适用人群:需要把实时语音接进业务流程的客服与销售团队、做跨语言协作的运营岗,以及自建实时交互链路的工程组。若只要单向语音转写或纯文本生成,通用模型更省成本;开源全双工路线可对照 MiniCPM-o 4.5。
MOSS-Live 的使用方法
两条路径对应两种载体:网页版直接开口对话,或经接口接进自己的系统。
网页端:在产品页点立即体验直接通话
- 打开模思智能 MOSS-Live 官网产品页,点「立即体验」。
- 进入通话界面后授予麦克风权限;要试屏幕共享与视频画面,再授予对应权限。
- 先用一个完整句子提问,再故意停顿两秒,观察它是等你还是抢答。
- 说到一半插一句「等一下」,确认它是否立即停下;接着说下去,看它是否从断点续说而非重来。
接口:在 MOSS API 控制台建 Key 接入
- 访问 MOSS API 控制台并完成注册登录,控制台为中文界面。
- 在 API Keys 页创建调用密钥,按项目分开管理。
- 按 API Docs 的实时交互指南接入
moss-live-1.0,走 WebSocket/v1/realtime,连接地址为wss://api.mosi.cn/v1/realtime?model=moss-live-1.0。 - 在「用量与积分」页核对调用记录,Beta 期限时免费、暂不扣积分,后续收费口径以控制台为准。
API Key 只放在服务端环境变量与 WebSocket 握手请求头中,不要写进浏览器前端代码。实时通话对上行带宽与麦克风权限有要求;视频画面与屏幕共享取决于浏览器授权,未授权时只剩语音。后台任务在结果就绪后带回对话,不会中断前台交流。
MOSS-Live 的项目地址
- 官网产品页:https://www.moss.cn/products/moss-live
- MOSS Create 创作平台:https://create.moss.cn/
- MOSS API 控制台:https://platform.moss.cn/
MOSS-Live 的价格与付费方案
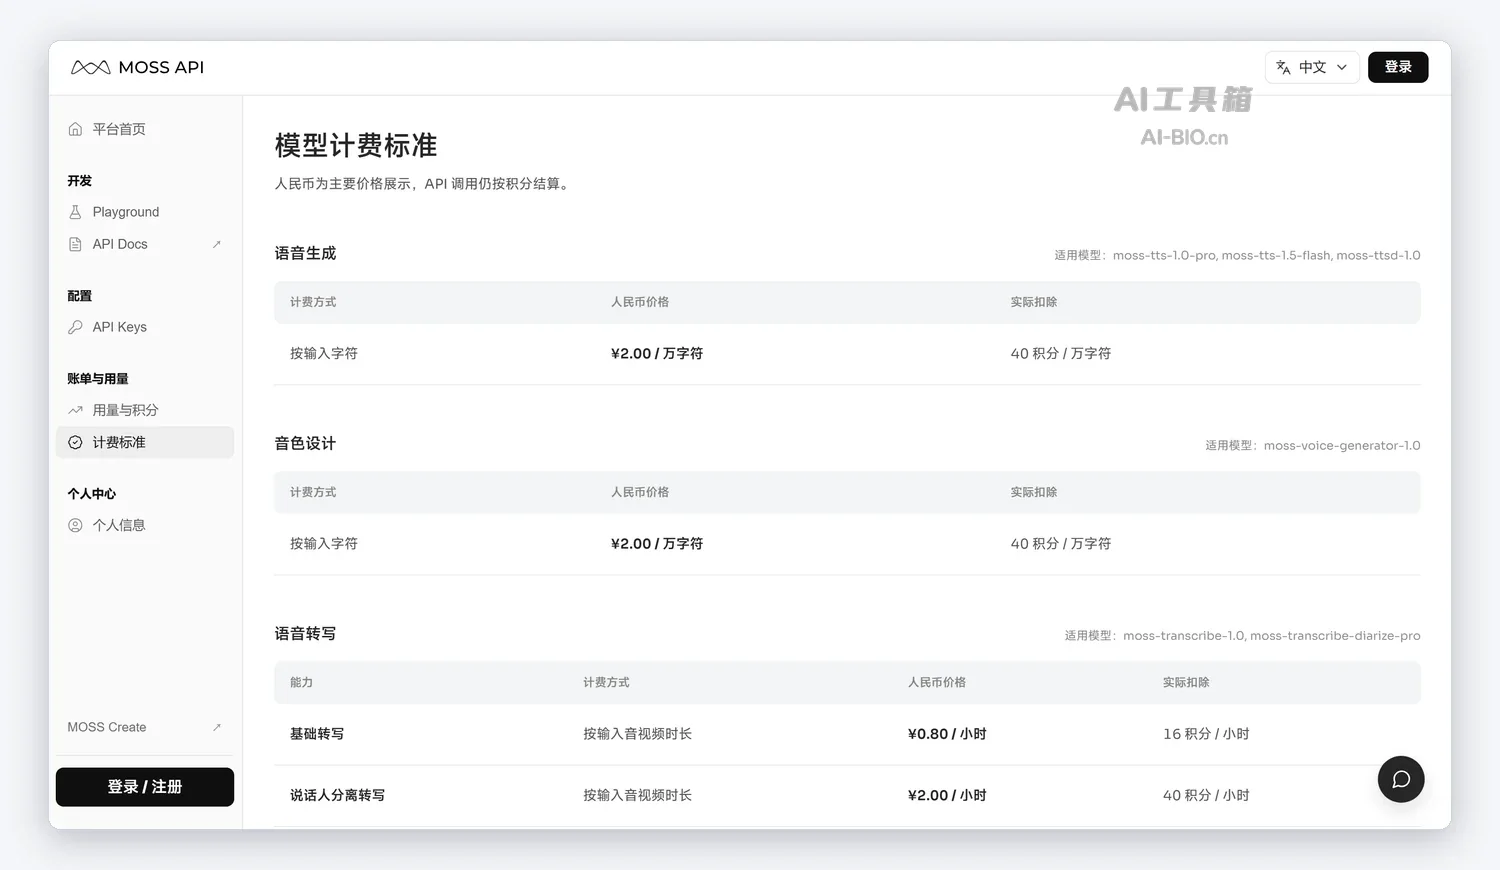
MOSS-Live 本身在官方模型页标注为 Beta 期限时免费、0 积分;MOSS API 平台上按积分挂牌的是语音生成、音色设计与语音转写三组服务,人民币参考价与积分扣除量并列给出:
- 语音生成:¥2.00 / 万字符,扣 40 积分,覆盖 moss-tts-1.0-pro、moss-tts-1.5-flash 与 moss-ttsd-1.0
- 音色设计:¥2.00 / 万字符,扣 40 积分,对应 moss-voice-generator-1.0
- 语音转写:基础档 ¥0.80 / 小时(16 积分),说话人分离档 ¥2.00 / 小时(40 积分)
- 企业方案:自定义配额,含专属服务、SLA 与技术支持
实时交互服务的收费政策尚未公布,调用暂不扣积分;官方文档写明计费按连接时长核算、断开后异步结算。个人配额不足时可另谈企业方案。
MOSS-Live 的常见问题
MOSS-Live 和普通语音助手有什么区别
主要差在听与说能不能同时进行。多数语音助手等你说完再回应,遇到停顿容易抢答;MOSS-Live 说话时持续接收输入,按语义判断你是在附和、思考还是真要打断,停顿不会触发抢话。
被打断之后它会从头说吗
不会。它只把真正说出口的部分计入上下文,被打断时清楚自己说到哪个字,之后从断点续说,也不会假设你听到了还没说出口的内容。
怎么把它接进自己的系统
经 MOSS API 接入:在控制台创建密钥,按文档以 moss-live-1.0 模型走 WebSocket /v1/realtime 建立会话,密钥只放在服务端;产品页同时提供网页端在线体验入口,适合先试效果再决定是否接入。
使用需要付费吗
当前 Beta 期限时免费、不扣积分,官方模型页已明确标注。MOSS API 平台上的语音生成、音色设计与语音转写按各自积分档位计费,实时交互服务的后续收费政策以官方更新为准。
相关文章

 浙公网安备33010202004812号