
Shieldstral快速摘要
Shieldstral是Mistral AI于2026年8月4日发布的策略自适应多模态安全分类模型,专注于生成式AI内容审核、智能体安全和模型风险检测,支持文本、图片以及图文混合内容分析,可作为AI应用安全防护组件部署。
- 开发公司:Mistral AI
- 发布时间:2026年8月4日正式发布,模型同步上线Hugging Face平台。
- 模型定位:面向AI安全检测、内容审核和生成式AI风险控制的策略自适应模型。
- 参数规模:采用3B参数设计,基础模型为Ministral-3-3B-Base-2512。
- 多模态能力:支持文本、图片、文本+图片三类安全审核输入。
- 上下文长度:训练采用最高32K tokens序列,理论支持256K上下文窗口,推荐保持32K以内。
- 语言支持:支持英语、中文、日语、韩语、法语、西班牙语等12种语言。
- 部署方式:支持vLLM、llama.cpp、SGLang和Transformers推理框架。
- 开源情况:采用Apache 2.0许可证开放权重,可用于商业和非商业场景。
- 硬件要求:BF16精度运行时可部署于单张16GB显存GPU环境。
Shieldstral的核心优势
- 策略自适应审核:通过自然语言输入安全规则,无需重新训练即可调整审核标准,适合动态内容审核场景,提升AI应用安全策略灵活性。
- 多模态安全检测:结合Ministral-3-3B-Base-2512与Pixtral视觉编码器,支持文本、图片、图文审核,VLGuard测试F1达到97.7%。
- 轻量部署能力:采用3B参数规模设计,BF16模式约需16GB显存即可运行,适合企业私有部署和实时AI安全检测。
- 单Token安全判断:将审核任务转化为yes/no问答,通过安全评分判断风险等级,降低推理复杂度,提高内容检测效率。
- 多语言支持能力:支持中文、英文、日语、韩语等12种语言,可用于全球化AI产品内容审核和智能体安全防护。
Shieldstral的主要功能
- 用户输入审核:通过Instruct、Query、Document结构检测用户提示词风险,可用于聊天机器人入口过滤和AI安全防护。
- AI回复审核:支持检测大语言模型生成内容,通过安全评分判断回复风险,降低模型输出违规信息概率。
- 图片内容审核:利用Pixtral视觉编码器分析图片安全风险,支持图片单独或图文组合内容检测。
- 智能体安全防护:可审核智能体任务指令和执行结果,帮助自动化系统降低错误操作和风险内容输出。
- 拒答能力检测:支持评估AI模型是否正确拒绝风险请求,用于大模型安全测试和效果评估。
Shieldstral的技术原理
- 基础架构:基于Ministral-3-3B-Base-2512构建,融合Pixtral视觉编码器,实现文本和图像统一安全分析。
- 输入机制:采用Instruct、Query、Document三字段设计,通过自然语言描述审核规则,提高策略调整能力。
- 推理机制:将安全检测转换为yes/no问答任务,通过单Token预测生成连续安全评分。
- 训练方式:针对安全分类数据训练,使模型理解不同审核策略,而非固定绑定单一风险标签。
- 上下文能力:训练支持32K tokens上下文,理论支持256K窗口,适合长文本安全检测任务。
Shieldstral与主流安全模型对比
| 对比维度 | Shieldstral | Llama Guard 4 | Qwen3Guard | GPT-OSS-Safeguard |
|---|---|---|---|---|
| 模型定位 | 策略自适应多模态安全分类 | 开源安全审核模型 | 大模型安全检测模型 | 安全防护模型 |
| 参数规模 | 3B | 12B | 8B | 20B |
| 多模态能力 | 文本、图片、图文审核 | 支持多模态安全任务 | 支持安全分类 | 主要文本安全 |
| 审核方式 | 自然语言策略输入 | 固定安全类别 | 安全标签分类 | 安全规则判断 |
| 部署需求 | 16GB GPU可运行 | 需要更高资源 | 中等资源需求 | 较高计算需求 |
从公开测试数据看,Shieldstral重点优势在轻量化和策略自适应能力。根据模型卡测试数据,Shieldstral在WildGuardTest提示词分类中F1达到88.1%,在ToxicChat测试中达到84.1%,HarmBench提示词分类达到99.4%。多模态安全测试中,Shieldstral在VLGuard达到97.7% F1。不同安全模型之间差异主要来自训练数据、安全策略设计和模型规模。较大模型通常拥有更多参数,而Shieldstral通过动态策略输入降低固定分类限制,更适合需要快速调整审核规则的AI应用。
如何使用Shieldstral
- 安装运行环境:准备Python和推理框架环境,推荐使用vLLM部署。安装vLLM后加载模型,官方示例要求vLLM版本不低于0.26.0,并配置
max-model-len 32768参数运行。 - 加载模型服务:通过模型名称mistralai/Shieldstral-1.0-3B启动推理服务,建议使用BF16精度运行,在16GB显存GPU环境中部署,提高本地安全检测效率。
- 设计审核规则:根据业务需求编写Query问题,例如“该内容是否包含暴力信息”,并通过Instruct设置严格程度,再输入Document完成安全判断。
- 接入业务系统:将Shieldstral部署为AI应用安全网关,对用户输入和模型输出分别检测。例如聊天机器人先审核问题,再审核答案,形成双向安全保护。
Shieldstral的局限性
- 语言覆盖差异:虽然Shieldstral支持12种语言,但不同语言训练数据分布存在差异,官方指出部分语言和领域覆盖不足时,安全判断可靠性可能下降。
- 数据噪声影响:安全训练数据包含公开数据和合成数据,即使经过筛选仍可能存在标签噪声,因此复杂安全场景需要结合人工审核机制。
- 复杂输入限制:对于编码隐藏攻击、混淆文本以及超长文档,模型可靠性可能降低,实际部署需要结合规则系统和其他安全组件。
Shieldstral相关资源
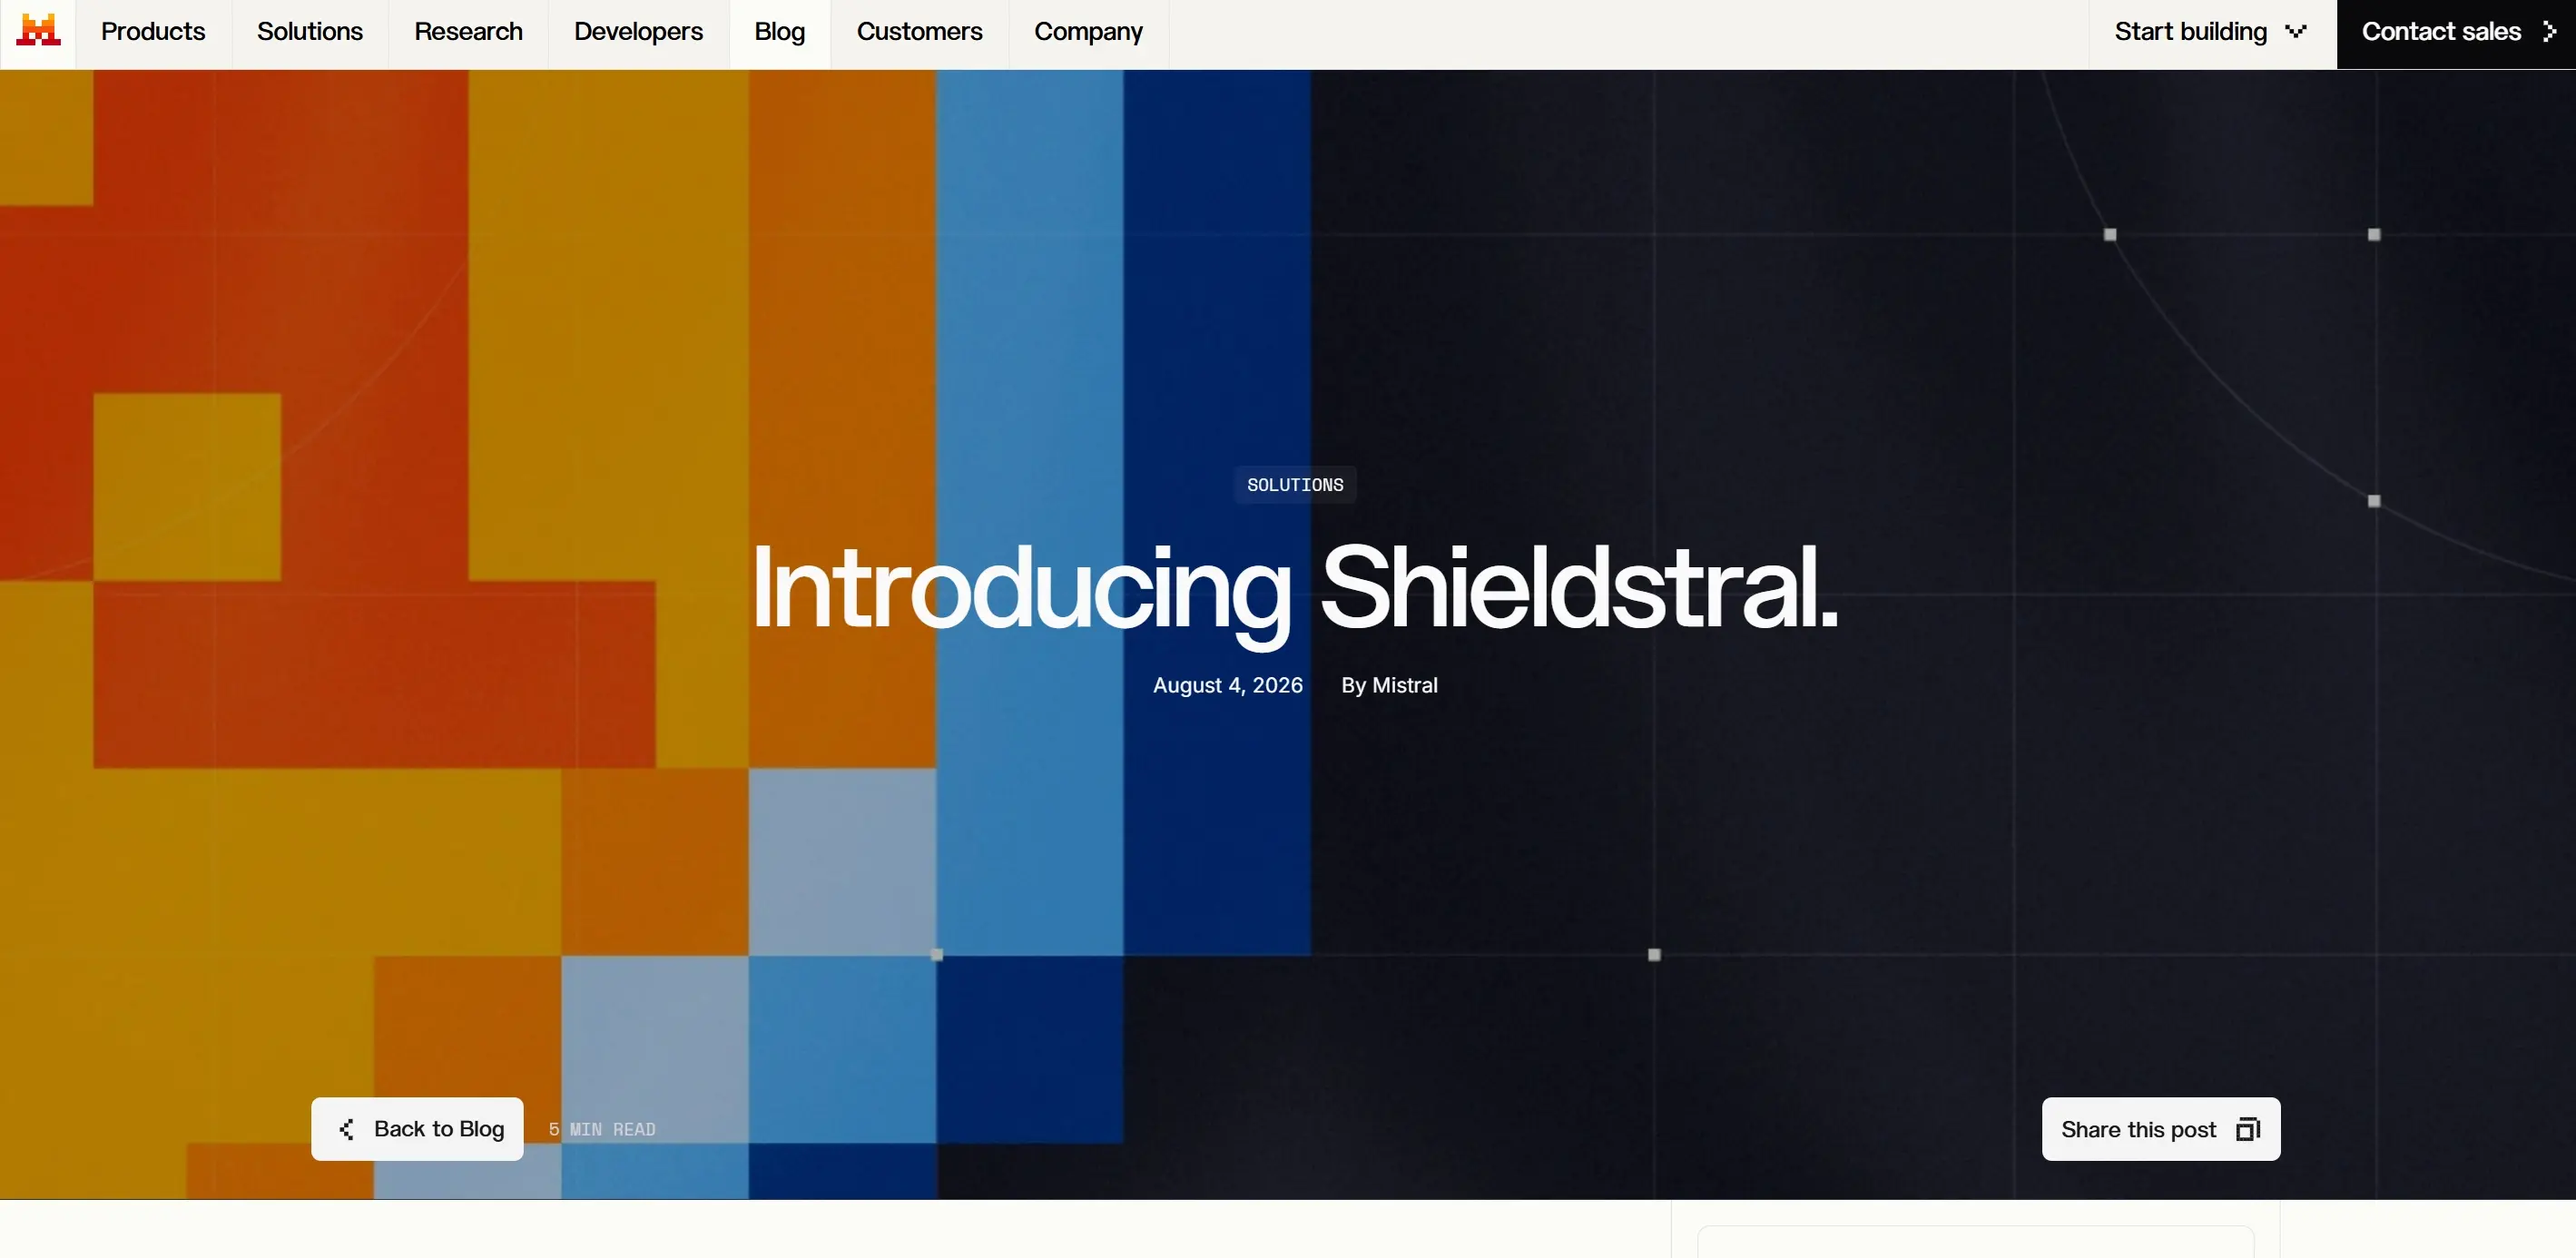
- 项目官网:Introducing Shieldstral
- HuggingFace模型库:https://huggingface.co/mistralai/Shieldstral-1.0-3B
- arXiv技术论文:https://arxiv.org/pdf/2607.25857
Shieldstral的典型应用场景
- 智能客服安全:用于检测客服机器人输入和回复内容,降低违规信息输出风险,提升企业AI客服安全管理能力。
- 智能体安全防护:可作为智能体安全组件,审核任务指令和执行内容,减少自动化流程中的风险操作。
- 内容平台审核:支持文本、图片和图文内容安全检测,适用于社区、论坛和内容平台的自动审核。
- 企业AI治理:帮助企业检测员工使用AI工具产生的内容,建立内部生成式AI安全管理流程。
- 模型安全评估:用于测试大语言模型输出质量,分析模型拒答能力和风险控制效果。
Shieldstral常见问题
Shieldstral怎么用?
Shieldstral需要通过vLLM、Transformers等框架部署,输入审核规则和待检测内容即可完成安全判断。建议开发者先本地测试,再接入实际业务系统。
Shieldstral免费吗?
Shieldstral采用Apache 2.0许可证开放权重,可免费用于商业和非商业开发。但部署运行仍需要GPU服务器资源,实际成本取决于硬件配置。
Shieldstral和Llama Guard哪个好?
Shieldstral支持动态安全策略和多模态审核,更适合规则变化频繁的场景。Llama Guard生态成熟,适合固定安全分类任务。
Shieldstral支持图片审核吗?
支持图片、文本以及图文混合审核,通过Pixtral视觉编码器处理视觉信息,可用于多模态内容安全检测。
Shieldstral可以本地部署吗?
可以本地部署,官方支持vLLM、llama.cpp、SGLang和Transformers,BF16模式约需16GB显存GPU,适合企业私有化部署。
© 版权声明
本站文章版权归AI工具箱所有,未经允许禁止任何形式的转载。
相关文章

AI工具箱导航官网汇集了来自国内外的上千款AI工具。每日更新和添加最新的AI工具。此外还收录了常用的AI学习开发网站、框架和模型。帮助你轻松跟上人工智能的步伐,实现任务自动化,提升工作效率!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。
 浙公网安备33010202004812号