
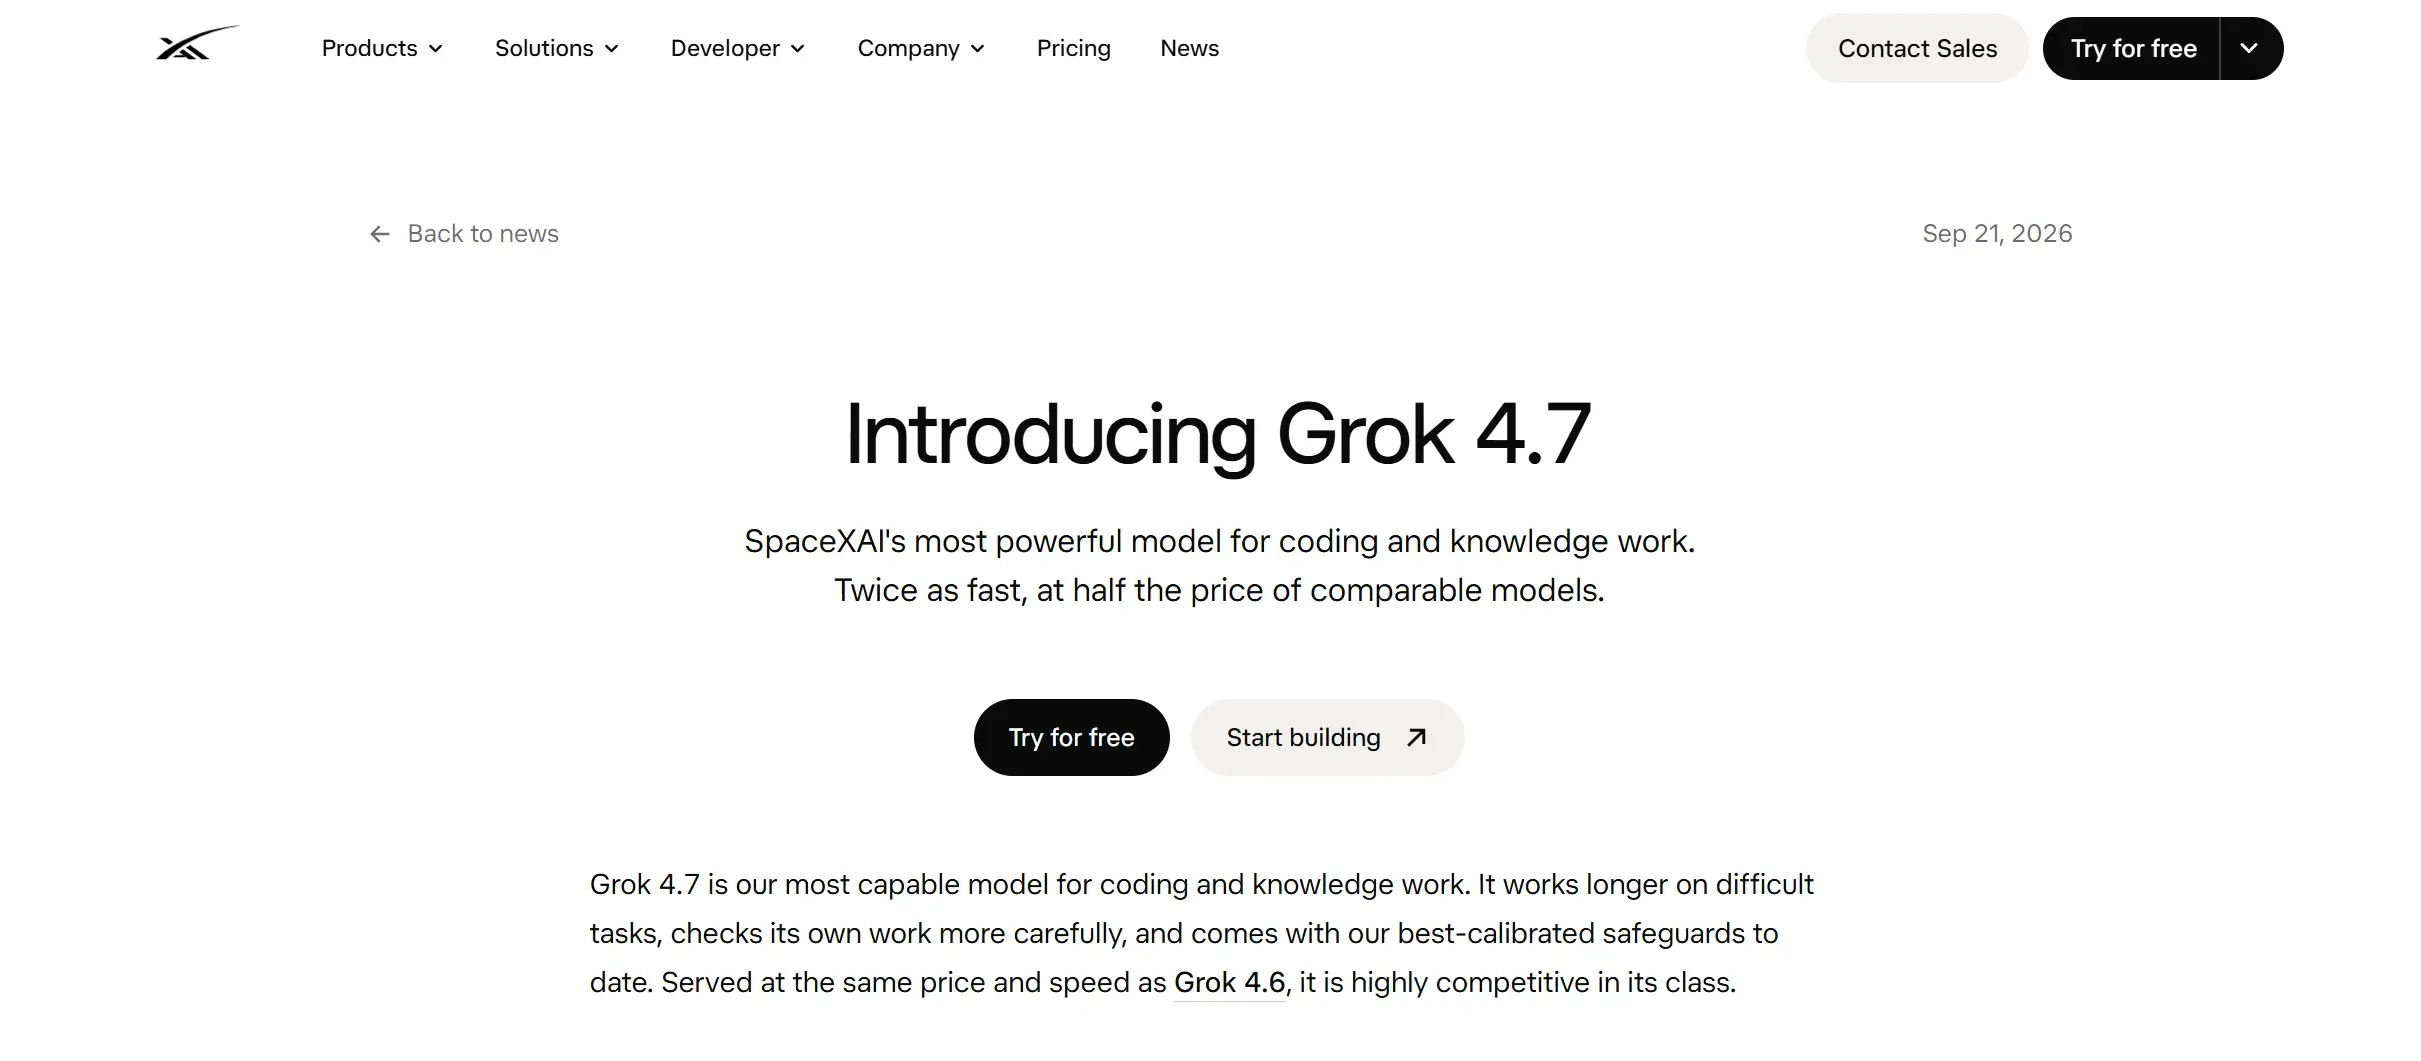
Grok 4.7是一款由SpaceXAI(xAI)于2026年9月推出的旗舰编码与知识工作大模型,主要用于长时间编码智能体任务与专业文档产出,支持 50 万 token 上下文与四档推理强度设置,适用于软件工程、法律检索与金融分析等知识工作场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向编码与知识工作的旗舰大模型 |
| 出品方 | SpaceXAI(xAI) |
| 发布时间 | 2026年9月21日 |
| 参数规模 | 2.1 万亿 |
| 上下文窗口 | 500,000 tokens |
| 输入与输出 | 文本、图像输入,纯文本输出 |
| 推理强度 | low / medium / high(默认)/ xhigh |
| 输入 / 输出定价 | 2 美元 / 6 美元(每百万 tokens) |
| 可用渠道 | xAI API、Cursor、Grok Build |
Grok 4.7 的核心能力
Grok 4.7 的改进集中在基础模型规模、强化学习时长与专业任务覆盖三处:它换用参数更大的基础模型,并把强化学习周期拉长到以数小时计的复杂任务上。对以 AI 智能体 为主要工作负载的团队而言,模型能否在长执行链中保持目标并减少返工,比单轮回答质量更影响实际成本。
更大的基础模型与更长的强化学习
参数规模由上一代的 1.5 万亿提升至 2.1 万亿,训练任务中需要数小时才能完成的样本占比更高。官方数据显示,CursorBench 4.0 由 40.4% 提升至 46.3%,Terminal-Bench 4.0 由 20.3% 提升至 38.0%,后者是本次提升幅度最大的一项。
专业知识工作与文档产出
官方评测覆盖法律、医疗、工程与办公文档任务:Harvey 法律基准由 15.8% 提升至 19.6%,EEBench 由 53.0% 提升至 64.0%,HealthBench Professional 由 48.5% 提升至 56.7%,GDPval 的 Elo 得分由 1605 提升至 1695。
长上下文与调用配置
上下文窗口为 50 万 token,知识截止 2026 年 5 月,支持文本与图像输入、纯文本输出。推理强度分 low、medium、high 与 xhigh 四档,默认 high;官方建议调用时携带 prompt_cache_key 以提高缓存命中率,长周期任务另建议启用上下文压缩。
安全防护与可用渠道
官方称该代在拒答与抵抗越狱方面为已测试模型中最强:生物安全评测 LatchBio 取得 62.4%,高风险网络安全基准 HackerBench v0.3 仅放行 3.3% 的双重用途提示。除 xAI API 与 Grok 应用外,Cursor、Grok Build 及第三方模型网关亦同步提供,Grok Build 已将其设为默认模型。
Grok 4.7 与同类旗舰模型的对比
| 对比维度 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|---|
| 开发方 | SpaceXAI(xAI) | SpaceXAI(xAI) | OpenAI | Anthropic |
| 输入价格(每百万 tokens) | 2 美元 | 2 美元 | 4 美元 | 10 美元 |
| 输出价格(每百万 tokens) | 6 美元 | 6 美元 | 20 美元 | 50 美元 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench(电气工程) | 64.0% | 53.0% | 39.4% | 56.4% |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey 法律基准 | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
上表逐行取自 SpaceXAI 官方发布页公布的对比表。定价上 Grok 4.7 与前代一致,输入与输出为每百万 token 2 美元与 6 美元,而 GPT-5.6 Sol 为 4 美元与 20 美元、Claude Fable 5.1 为 10 美元与 50 美元。能力侧的优势集中在电气工程与法律两类专业任务,EEBench 的 64.0% 与 Harvey 的 19.6% 均为该表最高值;在 CursorBench 4.0 与 HealthBench Professional 上仍低于 Claude Fable 5.1。以长程编码与终端任务为主、对单位成本敏感的场景可优先评估 Grok 4.7。
如果关注同一团队在编码链路前端的布局,可参考 Grok Build(xAI 推出的终端原生编程智能体与多智能体开发工具,Grok 4.7 已作为其默认模型接入)。
Grok 4.7 的应用场景与适用人群
该模型面向以数小时为单位的复杂任务与专业文档产出,常见落点包括:
- 软件工程与仓库维护:在既有代码仓库中完成需求拆解、跨文件修改、测试运行与反复纠错,适合把重复的工程任务交给智能体持续执行。
- 法律与合规检索:在 Harvey 基准覆盖的合同与判例类任务中产出初稿,再由专业人员复核,压缩前期资料整理时间。
- 金融分析与演示文稿:面向分析师的报表梳理、数据核对与演示文稿生成,官方针对文档与演示输出做了专门优化。
- 工程与硬件推理:EEBench 等电气工程评测显示该代在专业工程题上提升明显,可辅助硬件设计评审与故障日志分析。
- 企业内部知识工作:通话记录、工单与内部文档的整理与检索,建议先以只读权限验证,再逐步放开写操作。
适用人群:需要长时间运行编码智能体的研发团队、以文档与资料处理为主的专业服务团队,以及希望以更低单位成本获得接近前沿能力的企业。对数据出境与合规有硬性要求的用户,应先确认所用渠道的数据处理条款,再决定敏感任务是否接入。
Grok 4.7 的使用方法
从查阅资料到接入生产环境,可按以下步骤开始:
- 查阅官方说明:在 Grok 4.7 官方发布页了解能力范围、价格档位与推理强度设置,再确定需要接入的业务环节。
- 申请访问凭据:在 xAI 控制台创建项目并生成 API 密钥,按环境区分密钥,避免在客户端代码中直接写入。
- 发起调用:将模型名设为
grok-4.7,通过 Responses API 或 Chat Completions 发起请求;同一会话建议携带prompt_cache_key,以保证缓存命中与费用可控。 - 按任务设置推理强度:常规问答使用默认档,长时间编码与复杂推理任务提升档位,避免全部流量使用最高档。
- 接入编码工具链:在 Cursor 或 Grok Build 中直接选择 Grok 4.7,把终端执行、文件读写与测试环节交给工具编排,先在只读任务上验证行为边界。
落地建议先做小流量灰度,用低档位验证交互与延迟后按调用量切换付费档;涉及写操作的工具调用保留人工确认与回滚路径,并持续跟踪首包延迟、任务完成率与单任务成本三项指标。
Grok 4.7 的价格与开源情况
Grok 4.7 标准版定价为每百万 token 输入 2 美元、输出 6 美元,与 Grok 4.6 保持一致;提示不超过 20 万 token 时,缓存命中输入为每百万 0.5 美元。当单次提示超过 20 万 token,输入、缓存输入与输出分别调整为 4 美元、1 美元与 12 美元。美国区域端点按 token 用量加收 10% 溢价,Grok 4.7 Fast 按标准价格 2 倍计费,仅在 Cursor 与 Grok Build 提供。
Grok 4.7 为闭源商业模型,不开放模型权重与训练细节,仅通过 xAI API、Grok 应用、Cursor、Grok Build 及第三方模型网关提供,自托管与私有化部署不在可选范围内。对成本敏感的团队而言,缓存命中率是决定真实支出的关键变量,建议接入时统一携带会话标识并监控命中比例;对数据驻留有硬性要求的企业,应评估区域端点与网关方案的差异后再确定部署路径。
Grok 4.7 的常见问题
Grok 4.7 和 Grok 4.6 有什么区别?
Grok 4.7 参数规模由 1.5 万亿提升至 2.1 万亿,强化学习周期更长、任务更难,并扩大了专业任务评测覆盖。官方数据显示 CursorBench 4.0 由 40.4% 升至 46.3%、Terminal-Bench 4.0 由 20.3% 升至 38.0%,定价与速度不变。
Grok 4.7 的上下文窗口有多大?
上下文窗口为 50 万 token,知识截止 2026 年 5 月。单次提示超过 20 万 token 时输入与输出价格会上调,超长任务需按实际长度评估成本,并结合上下文压缩控制单任务开销。
Grok 4.7 怎么收费?
每百万 token 输入 2 美元、输出 6 美元,缓存命中输入 0.5 美元;提示超过 20 万 token 后为输入 4 美元、缓存输入 1 美元、输出 12 美元。美国区域端点加收 10% 溢价,Grok 4.7 Fast 按 2 倍费率计费。
相关文章


 浙公网安备33010202004812号