
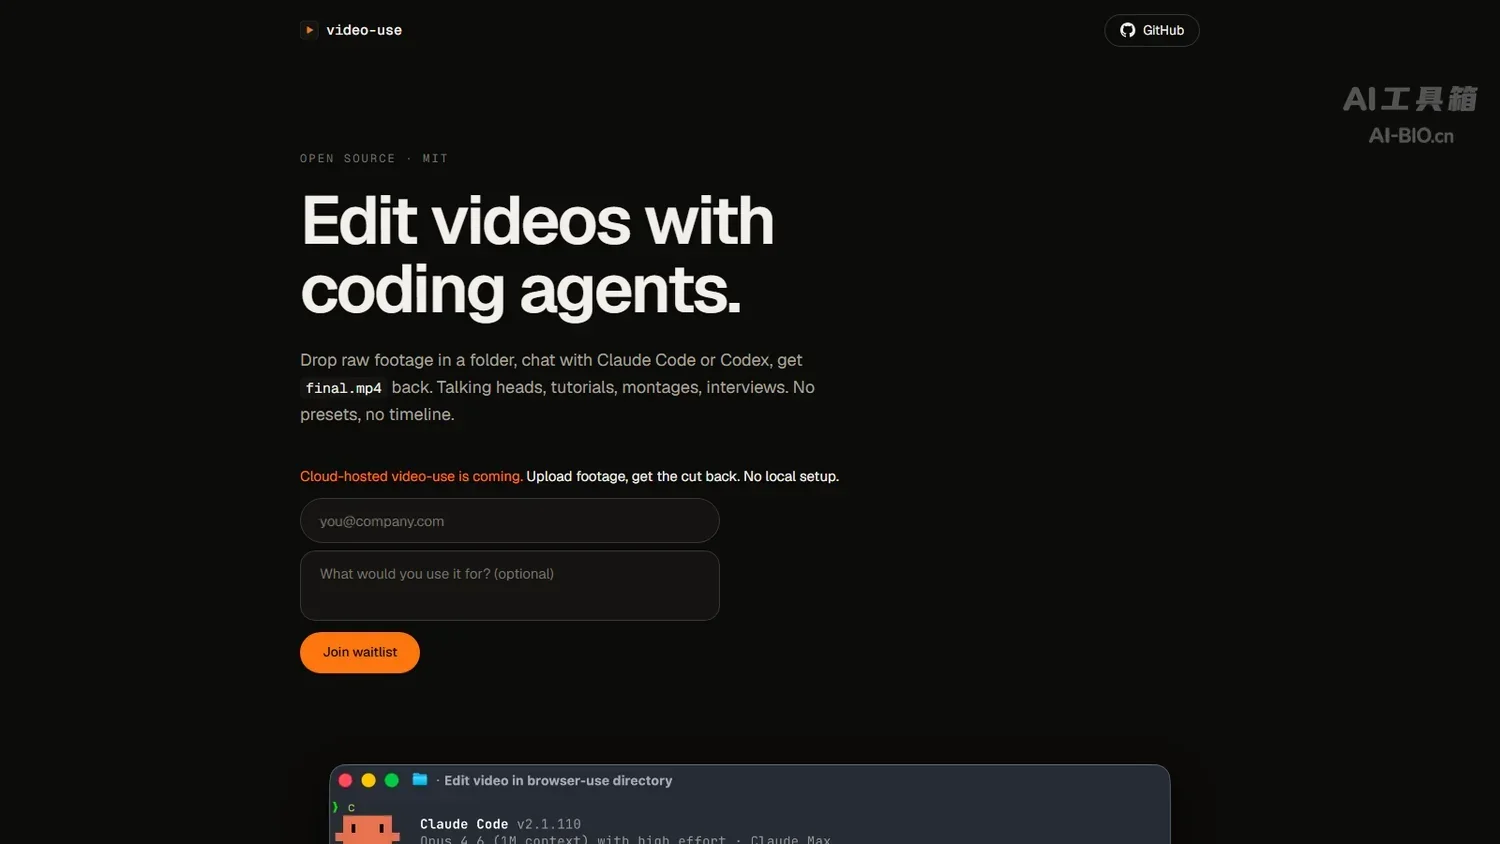
video-use 是一款由 Browser Use 团队于 2026 年 4 月开源的视频剪辑智能体,主要用于在编程智能体的对话里完成口播与访谈素材的整段剪辑,支持口癖与长停顿清除、自动调色与字幕烧录,适用于技术口播、教程与访谈类内容从原始素材到成片等场景。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向编程智能体的视频剪辑技能 |
| 出品方 | Browser Use 团队 |
| 项目创建时间 | 2026 年 4 月 12 日 |
| 开源协议 | MIT |
| 使用方式 | 编程智能体技能,Claude Code 可触发 |
| 素材来源 | 本地文件夹里的原始素材 |
| 转录依赖 | ElevenLabs 语音转录服务 |
| 内容理解 | 转录打包成约 12KB 文本,按需取关键帧与波形 |
| 动画引擎 | HyperFrames、Remotion、Manim、PIL |
| 质检修复 | 渲染后自检,最多 3 轮修复复检 |
| 项目记忆 | 剪辑决策写入 edit/project.md 供接续 |
video-use 的核心能力
video-use 把「剪辑」重新定义成了「读一份文本再下指令」:素材先被转成带说话人与音频事件的字级转录,多段打包成约 12KB 的文本,智能体读它决定切点,需要判断画面时才取关键帧。这个思路换来的是成本差别——官方的示意估算是三万帧逐帧分析约 4500 万 token(每帧按 1500 token 估算,非实测),而打包后的转录文本只有约 12KB。
口癖、死寂与废镜头一并剪掉
口头填充词与两次拍摄之间的长停顿可依据转录时间戳直接定位,说错重来的 take 则由智能体比较内容后决定取舍,判断依据是文本与音频事件,而不是逐帧画面,所以对着一堆素材只说一句「把这些剪成一支发布视频」,它就能先给出素材盘点再开始剪辑。
每个切点都补 30 毫秒淡变
硬切最容易暴露的问题是爆音。它在每个切点自动加 30 毫秒的音频淡入淡出,降低硬切爆音的概率,渲染后自检还会查切点波形兜底。这一条看似细节,实际决定了成片能不能直接发出去——手动剪辑时最常被漏掉的就是这个。
调色与字幕按预设执行
调色内置暖色电影感与中性增强两种预设,未提出调色要求时默认保持原片,也接受自定义 ffmpeg 滤镜链;字幕默认按短视频习惯切成两词一组的大写块,字体、颜色、位置可改。风格参数固化在项目里,同类内容反复产出时不会每支片都不一样。
动画叠加交给子智能体并行
需要 B-roll 或动画卡片时,按需求分派给 HyperFrames、Remotion、Manim 或 PIL 加 ffmpeg 的子智能体并行生成,每个动画一个子任务。主流程不必等所有渲染串行跑完,叠加层的产出与剪辑决策相互独立。
渲染完成后自己先检查一遍
成片渲染出来先做一轮自检:切点有没有跳帧、音频有没有爆音、字幕是否遮挡主体、叠加层有没有对齐错位。发现问题自动修复,最多三轮,仍不达标才交回人工复核。这一步把「逐帧检查成片」变成「只看结论」。
剪辑决策写成项目记忆
每次的判断——切点如何取舍、用了哪个调色预设、字幕走什么样式——追加记录到素材目录的 edit/project.md。隔几天接着剪同一系列时,之前定的策略还在,不需要重新解释一遍偏好。这份记忆只覆盖工具内部的判断;整条链路中人工与自动化如何分工,站内 AI 视频工作流拆解 有逐步对照。
video-use 与同类视频剪辑方案的对比
下表从交互形态、内容理解及质检环节等维度,对三个视频剪辑技能项目逐项对照。
| 对比维度 | video-use | ffmpeg-skill | OpenStoryline |
|---|---|---|---|
| 出品方 | Browser Use 团队 | 开源技能项目 | 小红书 FireRedTeam |
| 开源协议 | MIT | 开源 | Apache-2.0 |
| 交互形态 | 编程智能体对话触发 | 编程助手技能调用 | 对话加网页界面与命令行 |
| 内容理解 | 转录打包文本约 12KB | 由助手按指令调用 | 自动生成故事线与旁白 |
| 素材来源 | 本地原始素材 | 本地音视频文件 | 本地素材加在线媒体检索 |
| 动画与特效 | HyperFrames、Remotion、Manim、PIL | ffmpeg 滤镜链 | 转场生成与字体风格匹配 |
| 质检环节 | 渲染后自检,最多 3 轮修复复检 | 按指令逐步核对 | 对话式调整,未说明自动自检 |
- 表格内数据来源:video-use 与 OpenStoryline 取自各自官方仓库与产品页,ffmpeg-skill 取自其项目文档;三者均不做无中生有的镜头,素材质量仍是上限。
- 产品对比简述:交互形态上 video-use 接进编程智能体、OpenStoryline 自带界面、ffmpeg-skill 直接收命令;内容理解上,video-use 靠转录与按需画面检查定切点,OpenStoryline 侧重故事线生成与对话创作,ffmpeg-skill 按用户指令调用命令;质检仅 video-use 内置自动自检。
如果更习惯在图形界面里收尾,站内的 剪映Hub(剪映推出的一站式 AI 视频创作工作台)可以作为流程末端的一环,对照着看自动剪辑与人工精修的边界在哪。
video-use 的应用场景与适用人群
素材攒了一批、逐段剪起来最费时间时适用;需要逐帧精修或大量特效包装的,仍应交专业剪辑:
- 技术口播:把多次录制合成一条,口癖、停顿与废镜头自动去掉,字幕按短视频风格烧好。
- 教程与课程:长素材按讲点切段,段落之间补动画卡片说明步骤;需要在线精修时,站内的 Video Ocean 可作为末端补充。
- 访谈实录:按说话人整理转录后切出问答结构,素材顺序可按确认的剪辑策略调整。
适用人群:适合已经在用 Claude Code、Codex 这类编程智能体、并且手上有一批口播素材的内容团队,也适合想把剪辑流程固化成可复现脚本的技术型创作者;完全不接触命令行的用户,等云端版本更省事。站内另有一份多款视频工具的横向对照可供参照:图生视频工具对比。
video-use 的使用方法
video-use 只有一条入口:装成编程助手的技能,然后对着素材文件夹说话。装完之后,盘点、转录、剪辑与渲染都在本机由那个助手跑完。
- 从 video-use 官网 或仓库克隆代码到本地,进入目录执行
uv sync安装 Python 依赖。 - 安装 ffmpeg,复制
.env.example为.env并填入 ElevenLabs 的接口密钥用于转录。 - 把目录注册成技能:Claude 侧执行
ln -sfn ~/Developer/video-use ~/.claude/skills/video-use,Codex 侧链到~/.codex/skills/video-use(Windows 的注册路径与命令不同,按仓库install.md对应系统执行),重启编程助手使其识别。 - 把原始视频放进同一个文件夹,在该目录下启动编程助手,一句话说明目标,它会先输出素材盘点与剪辑方案。
- 确认方案后等待渲染,成片落在目录内的最终文件,自检不通过时会自动返工。
- 第一次剪完检查
edit/project.md里的决策记录,后续偏好用自然语言告诉助手即可接续;同系列多支片子分批跑,别一次把所有素材塞进同一个任务。
三点需留意:转录这一步依赖第三方服务,密钥与用量要自己管,素材敏感时先确认该服务的数据条款;逐帧判断只在关键节点发生,快速运镜或画面信息密集的素材,仍建议人工复核切点;项目记忆写在本地文件里,换机器或换目录需要把 edit/ 项目文件一起带走。另一条路线是把成片放进在线编辑器二次加工,站内的 InVideo 是这类工具的代表。
video-use 的项目地址
- 产品官网:https://video-use.com
- 项目仓库:https://github.com/browser-use/video-use
video-use 的价格方案
项目本身开源免费,协议为 MIT,代码可自行修改与商用。实际成本来自外部依赖:语音转录按 ElevenLabs 的用量计费,使用 Claude Code、Codex 等编程智能体可能产生模型费用;ffmpeg、PIL 与各动画引擎均可在本地运行,渲染不产生额外费用。
官网页脚另有一个云端托管版本处在预告状态,提供登记入口,正式上线后的计费方式官方尚未公布。现阶段想控制成本,做法是把转录控制在必要范围内:只对需要剪的素材做转录,成片渲染全部放本地。
video-use 的常见问题
必须用 Claude Code 吗
不必须。官网写的是与 Claude Code 或 Codex 对话触发,仓库的做法是把项目目录注册成技能,理论上任何能调用本地技能的编程智能体都能接。
为什么它能读懂视频
它不做逐帧视觉分析,而是把每条素材转成带说话人与音频事件的转录,多段打包成约 12KB 的文本让模型读;只有需要判断画面时才取关键帧与波形。官方的示意估算是三万帧逐帧分析约 4500 万 token,为估算案例而非实测。
字幕能改样式吗
可以。默认按短视频习惯切成两词一组的大写块,字体、颜色与位置都可调,也可自定义分组与排版。
剪辑偏好会丢吗
不会。每次决策追加写入素材目录的 edit/project.md,同一目录下继续工作时会沿用之前的策略;换目录需要把这份文件一并复制过去。
云端版现在能用吗
还不能。官网标注云端托管版本即将推出,只提供等待名单登记,正式上线时间与价格官方未公布。
相关文章


 浙公网安备33010202004812号