
SenseNova U1.5-Lite-Preview快速摘要
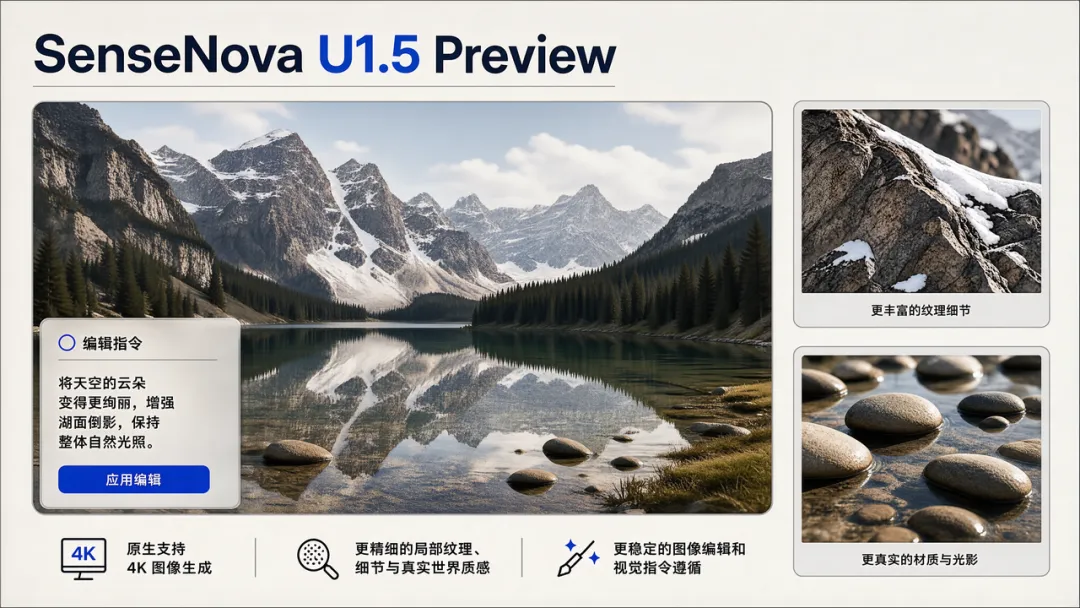
SenseNova U1.5-Lite-Preview是商汤科技推出的8B-MoT原生统一多模态模型,于2026年7月31日开放模型资源,并于2026年8月3日正式公开介绍,支持视觉理解、图像生成、图像编辑和多参考图融合等能力,适用于AI设计、视觉内容生成和多模态应用场景。
- 开发公司:商汤科技,模型基于NEO-unify架构研发,定位为原生统一多模态模型。
- 发布时间:2026年7月31日开放模型资源,2026年8月3日通过官方渠道公开介绍。
- 主要功能:支持图像生成、图像编辑、视觉理解、多参考图融合、区域可控编辑和长上下文视觉控制。
- 使用要求:需要根据模型仓库提供的环境配置和推理参数进行部署使用。
- 开源情况:已开放模型资源,开发者可获取相关文件进行研究和部署。
- 技术特点:采用8B-MoT架构,引入Encoder-Free视觉建模、ConvDecoder重建机制和Prompt Enhance能力。
SenseNova U1.5-Lite-Preview的核心优势
- 原生统一多模态架构:基于NEO-unify架构构建,采用8B-MoT设计,将视觉理解、图像生成和编辑能力统一处理,适合复杂图文任务。
- 长上下文视觉控制:支持复杂Prompt理解,可处理多层级视觉约束。官方案例显示支持3000词以上创作需求,并完成WAIC长卷生成任务。
- 高质量图像生成:支持4K图像生成和10:3超宽比例创作,Qwen-Image-Bench测试评分由U1版本47.14提升至55.20。
- 精细图像编辑:支持Mask、Bounding Box和Visual Marker区域控制方式,ImgEdit-Bench测试评分由3.90提升至4.37。
- 编辑能力优化:通过清洗编辑数据、扩展多参考图训练和优化中英文数据比例,提升复杂视觉编辑任务执行效果。
SenseNova U1.5-Lite-Preview的主要功能
- 文本生成图像:根据文本Prompt生成视觉内容,支持主体、风格和布局控制,可完成海报、插画和信息图等内容创作。
- 多参考图融合:支持多个图片作为输入,融合角色、商品和场景元素,生成符合指定视觉要求的新图像。
- 区域可控编辑:支持Mask、边界框和视觉标记编辑方式,可指定局部区域进行修改,提升图片调整精度。
- 信息图生成:支持文字、图形和布局结合的视觉内容生成,可用于知识展示、报告设计和内容整理。
- Prompt Enhance增强:可扩展简单提示词,将基础需求补充为更完整视觉描述,提高复杂生成任务的指令遵循能力。
SenseNova U1.5-Lite-Preview的技术原理
- NEO-unify架构:采用原生统一多模态架构,将文本和视觉信息联合建模,支持生成、理解和编辑任务协同推理。
- Encoder-Free视觉建模:减少传统视觉编码过程中的信息压缩损失,加强文字细节、纹理结构和空间关系保持能力。
- ConvDecoder重建机制:采用ConvDecoder替代MLP Head,并结合Patch-Joint Reconstruction优化图像细节恢复效果。
- 视觉编辑训练优化:通过编辑数据清洗、多参考图扩展和中英文数据优化,提高模型对复杂编辑需求的理解能力。
- Prompt增强推理:结合Prompt Enhance扩展视觉描述信息,使模型能够更准确执行复杂图像生成和编辑指令。
SenseNova U1.5-Lite-Preview与主流模型对比
| 对比维度 | SenseNova U1.5-Lite-Preview | Qwen-Image-3.0 | Emu3 |
|---|---|---|---|
| 模型定位 | 原生统一多模态模型,侧重视觉生成与编辑 | 第三代图像生成基础模型,侧重复杂视觉创作 | 统一多模态基础模型,侧重理解与生成统一 |
| 架构路线 | 基于NEO-unify架构,8B-MoT模型 | Qwen-Image系列图像生成架构 | 自回归统一多模态架构 |
| 生成能力 | 支持4K生成、长Prompt和复杂视觉指令 | 支持4.5k token输入和复杂布局生成 | 支持文本到图像生成任务 |
| 编辑能力 | 支持Mask、Bounding Box、Visual Marker区域编辑 | 支持图像编辑和视觉内容优化 | 主要强调多模态理解与生成 |
| 文字处理 | 优化中文英文文字、海报和信息图生成 | 支持多语言文字渲染和复杂版式生成 | 公开资料重点关注统一多模态能力 |
| 适用场景 | AI设计、信息图、图片编辑和视觉创作 | 商业设计、内容生成和复杂视觉制作 | 多模态研究和模型开发 |
SenseNova U1.5-Lite-Preview、Qwen-Image-3.0和Emu3均属于新一代多模态模型方向,但应用重点不同。SenseNova U1.5-Lite-Preview基于NEO-unify架构,重点提升图像生成、编辑和复杂视觉指令执行能力;Qwen-Image-3.0更关注高质量图像生成、复杂布局和文字渲染;Emu3主要探索统一多模态建模。根据公开测试数据,SenseNova U1.5-Lite-Preview在Qwen-Image-Bench达到55.20分,在ImgEdit-Bench达到4.37分,更适合视觉设计和编辑场景。
如何使用SenseNova U1.5-Lite-Preview
- 获取模型资源:访问模型仓库获取SenseNova-U1.5-8B-MoT Preview相关文件,根据环境要求完成安装配置。建议先确认硬件环境和依赖版本,避免部署过程中出现兼容问题。
- 配置推理环境:根据模型说明设置推理参数,例如cfg_scale设置为4.0、timestep_shift设置为3.0、num_steps设置为50,可用于基础图像生成测试并调整输出效果。
- 输入视觉提示词:输入包含主体、场景、风格和布局要求的Prompt,例如“生成一张科技产品发布会海报,包含标题文字和未来城市背景”,提高模型对目标内容的理解。
- 执行图像编辑:上传参考图片并结合Mask、Bounding Box或Visual Marker指定修改区域,例如修改人物服装或调整局部元素,提升编辑准确性。
- 优化生成结果:通过Prompt Enhance扩展描述内容,增加细节约束和视觉要求,可进一步改善复杂任务中的生成一致性。
SenseNova U1.5-Lite-Preview相关资源
- GitHub仓库:SenseNova-U1.5-8B-MoT (Preview)
- HuggingFace模型库:https://huggingface.co/sensenova/SenseNova-U1.5-8B-MoT-Preview
- 魔搭社区:https://modelscope.cn/models/SenseNova/SenseNova-U1.5-8B-MoT-Preview
SeSenseNova U1.5-Lite-Preview的典型应用场景
- AI设计制作:适用于海报、插画、品牌视觉等内容生成,可根据文字描述快速创建符合主题要求的设计素材。
- 电商视觉创作:支持商品图片优化、多场景展示和营销素材生成,帮助商家提升商品页面视觉效果。
- 信息图制作:支持文字、图形和布局结合的信息内容生成,可用于知识整理、报告展示和数据可视化设计。
- 图片编辑优化:支持局部区域调整、多参考图融合等功能,可用于人物修改、场景替换和创意再设计。
- 智能视觉应用:结合多模态理解和生成能力,可用于内容创作工具、设计辅助系统等视觉智能应用开发。
SenseNova U1.5-Lite-Preview常见问题
SenseNova U1.5-Lite-Preview怎么用?
SenseNova U1.5-Lite-Preview需要先获取模型资源并完成环境配置,然后通过文本Prompt或参考图片进行图像生成和编辑。建议从简单任务开始测试,再尝试复杂视觉指令。
SenseNova U1.5-Lite-Preview支持API调用吗?
SenseNova U1.5-Lite-Preview目前公开资料未公布API调用方式和价格信息。开发者可通过模型资源进行研究部署,并关注官方后续服务更新。
SenseNova U1.5-Lite-Preview和Qwen-Image-3.0哪个好?
SenseNova U1.5-Lite-Preview和Qwen-Image-3.0定位不同,前者基于NEO-unify架构,侧重图像生成、区域可控编辑和多模态统一能力;后者侧重高质量图像生成、复杂布局和文字渲染。选择时需根据视觉编辑需求、生成效果和部署方式综合判断。
SenseNova U1.5-Lite-Preview支持免费使用吗?
SenseNova U1.5-Lite-Preview已开放模型资源,但目前未公布免费额度信息。开发者使用前需要根据模型要求准备运行环境和计算资源。
SenseNova U1.5-Lite-Preview有哪些限制?
当前模型主要聚焦视觉生成和编辑任务,其他模态能力暂无完整公开评测数据。实际应用时需要结合任务类型验证效果和部署成本。
相关文章


 浙公网安备33010202004812号