
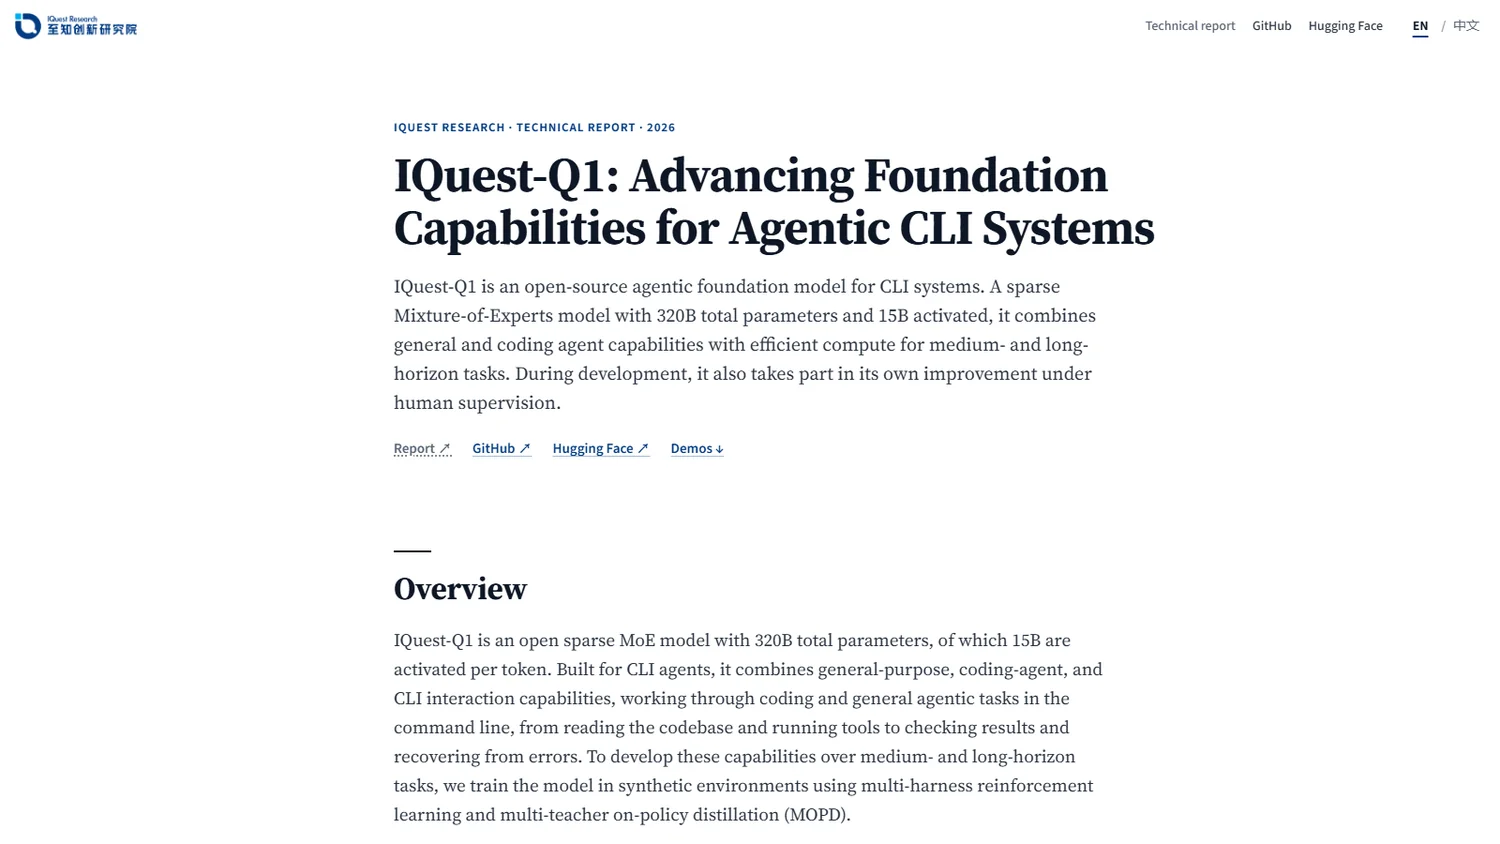
IQuest-Q1是至知创新研究院于2026年9月开源的Agent 基础模型,主要用于命令行智能体与仓库级代码任务,采用稀疏 MoE 架构,总参数 320B、每个 token 仅激活 15B,可以接入 Claude Code 或 Codex 使用。
| 基础信息 | 内容 |
|---|---|
| 产品定位 | 面向命令行智能体的开源模型 |
| 出品方 | 至知创新研究院 |
| 发布时间 | 2026年9月28日 |
| 参数规模 | 320B MoE(激活 15B) |
| 上下文长度 | 512K token |
| 注意力结构 | 3 层滑动窗口 + 1 层全注意力 |
| 开源许可 | Modified MIT |
| 可接入工具 | Claude Code、Codex |
| 权重获取 | Hugging Face 权重 |
IQuest-Q1 的核心能力
命令行智能体的能力上限,往往取决于底层模型能不能读懂一个真实仓库:既要定位跨文件的依赖关系,也要在工具调用出错后自行恢复。IQuest-Q1 的训练目标正对准这一段。理解这类能力,可以先了解 AI 智能体 的执行方式。
仓库级代码生成
一句话需求可以生成完整可运行的多文件项目,模型需要在多个文件之间维持一致的结构与接口。官方公布其在 NL2Repo 仓库级生成榜单上为 63.0 分,位列开源模型第一梯队。
CLI 智能体操作
模型能读写代码库、调用命令行工具、检查执行结果并从错误中恢复,可以直接接入 Claude Code 与 Codex 使用。相比只输出代码片段的模型,它更强调在真实终端环境里把任务跑完。
前端交互应用生成
一次生成可以包含 3D 场景、交互逻辑与视觉呈现的可运行网页应用。官方展示了 FPS 游戏、赛车游戏与体素海底城市等例子,用来体现模型对场景搭建与交互逻辑的整体把握。
办公流程自动化
通过飞书的 lark-cli,模型可以交叉核对聊天记录与文档,完成事件定级、报告撰写、任务分配与进度跟踪的完整闭环。这类任务的难点不在单步操作,而在多轮信息的对齐与复核。
AI 研发自我诊断
模型能够追查强化学习训练中的异常,定位根因、修复代码并用新的指标曲线验证结果。官方举过一个例子:模型在排查训练代码时发现文本解码阶段多出一个空格,导致多轮轨迹只有最后一轮进入损失计算。
IQuest-Q1 与同类模型的对比
下表从参数规模、能力侧重与公开评测等维度,对比三款常被放在一起评估的模型。
| 对比维度 | IQuest-Q1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|
| 参数规模 | 320B MoE(激活 15B) | 552B MoE(输入激活 8B / 输出激活 16B) | 7430 亿 MoE |
| 产品定位 | 面向命令行智能体的开源基础模型 | 原生多模态低成本主力模型 | 编程与网络安全特化开源模型 |
| 能力侧重 | 仓库级代码生成、工具调用与研发诊断 | 原生多模态理解与低成本推理 | 代码审计、漏洞发现与 Agent 推理 |
| 公开评测 | NL2Repo 63.0、CyberGym 84.5 | CyberGym 88.1、DeepSWE 74.2 | CyberGym 84.5、编程能力较上代提升约 50% |
| 集成方式 | 可接入 Claude Code 与 Codex,支持 SGLang 与 vLLM 部署 | 以官方 API 服务为主 | 通过 ZCode、AutoClaw、扣子等渠道调用 |
| 适用人群 | 做仓库级代码生成与漏洞挖掘的团队 | 需要低成本多模态能力的开发者 | 企业安全团队与软件研发团队 |
上表 IQuest-Q1 一列取自其官方模型卡与项目说明,DeepSeek-V4.1-Flash 与 GLM-5.3 两列取自各自官方资料。三者的取舍方向不同:IQuest-Q1 把命令行智能体作为主战场,强调仓库级生成与工具链路闭环;DeepSeek-V4.1-Flash 以低成本与原生多模态作为主力档定位;GLM-5.3 在代码审计与漏洞发现上做了专项训练。选型时可以先明确任务属于代码工程、多模态理解还是安全审查,再看是否需要模型自带工具调用能力。
如果想先了解这类模型常被接入的编程智能体,可以参考 Codex(OpenAI 推出的编程智能体,与 IQuest-Q1 同属命令行开发场景,区别在于前者是完整的智能体产品,后者是可以驱动智能体的基础模型)。

IQuest-Q1 的应用场景与适用人群
把仓库级代码能力与工具调用放在一起之后,常见用途包括:
- 智能编程开发:一句话生成完整可运行的多文件项目,在 Claude Code 或 Codex 中自主读代码、修缺陷、跑测试,交付可验证的工程成果。
- 交互式网页与游戏生成:根据文字描述一次性产出 3D 游戏、可视化工具与设计页面,覆盖场景搭建、交互逻辑与视觉呈现。
- 办公流程自动化:打通聊天、文档、表格与会议信息,完成信息交叉核验、事件定级、报告撰写、任务分配与进度跟踪。
- AI 研发与训练运维:自动诊断模型训练异常,定位根因并修复代码,辅助研发团队维护和优化自己的训练管线。
适用人群:做仓库级代码生成、终端智能体与训练运维的技术团队,以及需要把办公流程串成闭环的研发与运营人员。模型目前为纯文本输入,官方也提示它仍处于早期阶段,在真实命令行任务中需要人工复核结果。
IQuest-Q1 的使用方法
从获取权重到接入智能体,可按以下步骤操作:
- 获取模型权重:从 Hugging Face 或 GitHub 仓库下载模型权重与推理代码。
- 部署推理服务:用
SGLang或vLLM启动 OpenAI 兼容的推理服务,需要 8 卡张量并行与 bfloat16 精度,并加载 IQuest 格式的 tool-call 与 reasoning 解析器。 - 加速与调参:如需更高吞吐可以启用递归 MTP 投机解码;复现官方评测建议使用
temperature=1.0、top-p=0.95与top-k=20。 - 直接调用模型:通过 Python API 或 OpenAI 兼容接口发起请求,使用 IQuest 格式的 chat template 完成工具调用与推理。
- 接入 Agent 工具:通过支持工具调用的网关接入 Claude Code 或 Codex,设置好网关地址与 API Token 后即可驱动智能体完成任务。
- 验证与迭代:先用一个真实仓库完整走一遍任务链路,确认工具调用格式、显存占用与延迟都在可接受范围内,再扩大使用范围。官方项目地址见 IQuest-Q1 官方仓库。
建议先在多卡环境下完成一次完整任务验证,确认解析器与智能体框架的版本匹配,再投入实际使用;官方也提示模型在真实命令行任务中需要人工监督,交付前应保留复核环节。
IQuest-Q1 的价格与开源情况
IQuest-Q1 的权重与模型卡在 Hugging Face 上发布,GitHub 上的推理代码采用修改版 MIT 许可,允许商用,但要求在商业产品或服务的界面显著标注 IQuest-Q1。模型权重的许可标识与推理代码并不相同,采用前需要分别确认。
模型目前没有公开的托管在线服务,使用需要自行准备多卡环境,成本主要落在 GPU 与推理框架上;正式投入前建议先按自己的任务规模估算显存与吞吐需求,再决定部署方式。
IQuest-Q1 的常见问题
IQuest-Q1 可以商用吗?
可以。GitHub 上的推理代码采用修改版 MIT 许可,允许商用,但要求在商业产品或服务界面显著标注 IQuest-Q1;模型权重的许可以 Hugging Face 页面标注为准。
IQuest-Q1 怎么部署?
官方推荐用 SGLang 或 vLLM 启动 OpenAI 兼容服务,需要 8 卡张量并行与 bfloat16 精度,并加载对应的 tool-call 与 reasoning 解析器。
IQuest-Q1 能接入 Claude Code 或 Codex 吗?
可以。模型提供 OpenAI 兼容接口与官方 Docker 镜像,通过支持工具调用的网关接入 Claude Code 或 Codex 之后,即可用它驱动智能体完成任务。
相关文章


 浙公网安备33010202004812号