
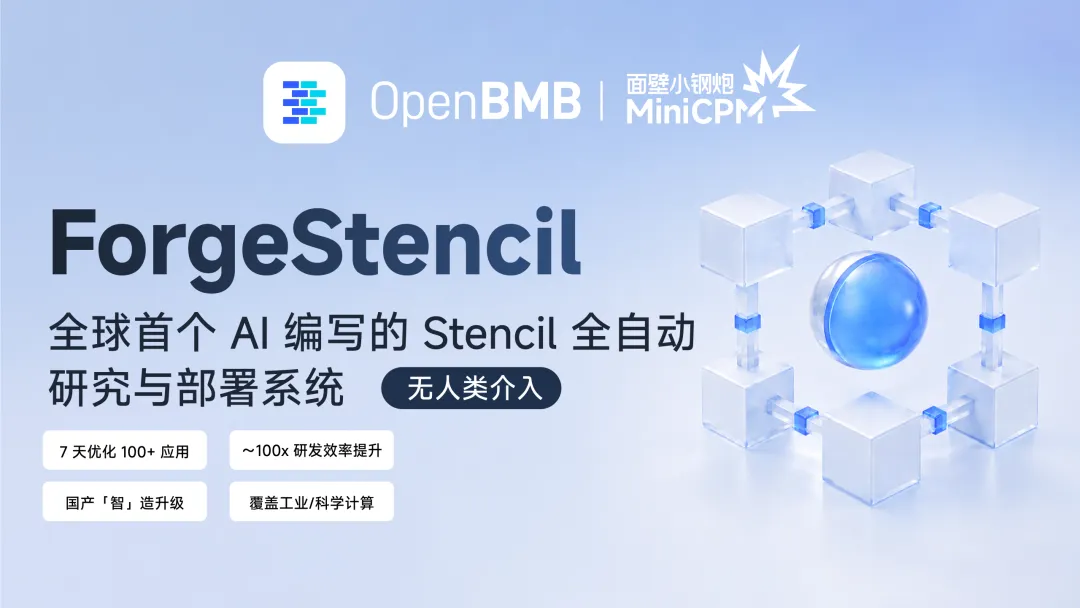
ForgeStencil快速摘要
ForgeStencil是面壁智能联合OpenBMB开源社区推出的AI优化系统,于2026年8月开源发布,面向工业软件与科学计算中的Stencil模板计算优化。该系统通过双智能体架构实现从优化策略发现、CUDA算子生成到真实应用部署的自动化流程,适用于高性能计算、工业仿真、医学影像、能源计算等场景。
- 开发团队:面壁智能联合OpenBMB开源社区,项目采用Apache-2.0开源协议。
- 发布时间:2026年8月4日正式开源发布
- 使用要求:支持NVIDIA GPU环境,已在A100-SXM4-80GB、CUDA 12.x环境完成验证。
- 开源情况:项目代码公开,可通过GitHub获取完整工程与复现实验配置。
- 技术特点:采用Kernel智能体与App智能体协同机制,实现优化研究与部署闭环。
- 价格:项目本身开源免费使用,实际运行成本取决于GPU算力资源。
ForgeStencil的核心优势
- 双智能体自动优化:通过Kernel智能体与App智能体协同,实现算子研究、代码生成、应用部署闭环,100个真实应用完成验证,端到端中位加速达到1.41×。
- 真实软件优化:直接针对工业与科学计算软件优化,以应用自身GPU代码作为基线测试,避免简单Benchmark结果偏差,几何平均加速达到2.05×。
- 自动策略发现:利用智能体探索分块、融合、内存布局等GPU优化策略,不依赖固定规则搜索,在Stencil算子测试中取得约2.16×几何平均加速。
- 可审计性能验证:采用单开关切换原始代码与优化代码,结合程序自带校验和计时机制,保证加速结果具备可复现和可验证特点。
- 跨GPU架构支持:支持A100、H100、B200等NVIDIA GPU架构,通过运行时分发选择优化算子,提高不同硬件环境下的适配能力。
ForgeStencil的主要功能
- 自动生成优化算子:通过CUDA算子智能体分析Stencil计算结构,生成高性能GPU代码,例如star_1、shape 256任务可自动完成算子测试。
- 定位性能热点:分析真实软件源码中的计算瓶颈,识别Stencil循环和关键函数,为后续GPU优化提供目标位置。
- 自动集成部署:利用App智能体完成算子替换、代码补丁生成和应用验证,例如gprMax/FDTD优化后获得2.47×加速。
- 性能自动测试:结合应用自带正确性检测和测试流程,对优化版本进行验证,输出真实软件环境下的性能变化数据。
- 结果复现实验:提供测试脚本和结果注册表,用户可运行tools/run.py等工具复现算子性能和应用优化结果。
ForgeStencil的技术原理
- 双智能体架构:采用Kernel智能体和App智能体协同模式,Kernel负责算子研究,App负责应用集成,实现从优化发现到部署验证流程。
- 智能优化搜索:基于大模型驱动智能体探索tiling分块、算子融合、内存布局等GPU优化方式,提高Stencil计算执行效率。
- 算子知识库:Kernel智能体持续积累优化算子矩阵,将已有优化经验复用于后续任务,提升多应用优化效率。
- 硬件感知优化:根据GPU架构特征选择不同优化路径,支持sm_80、sm_90、sm_100架构,提高A100/H100/B200适配能力。
- 可验证执行机制:采用patch方式集成优化代码,通过原程序校验机制验证结果,确保优化性能和计算正确性。
ForgeStencil与主流优化工具对比
| 对比维度 | ForgeStencil | Halide | Devito |
|---|---|---|---|
| 优化方式 | 智能体自主发现策略 | DSL调度优化 | 符号计算优化 |
| 应用范围 | 真实工业软件 | 图像和计算管线 | 地震模拟 |
| 部署能力 | 自动集成应用 | 需要人工接入 | 依赖开发流程 |
| 性能验证 | 真实GPU代码基线 | 框架测试 | 算法测试 |
| GPU支持 | A100/H100/B200 | 多平台支持 | GPU后端支持 |
ForgeStencil与Halide、Devito等工具的主要差异在于优化目标不同。传统工具通常关注代码生成或领域专用优化,而ForgeStencil进一步增加了自动策略探索和应用部署能力。根据项目公开测试数据,ForgeStencil在32个Stencil案例中,相比公开最佳基线取得约2.16×几何平均加速,其中star_1、star_2、box_1等任务均进行了同精度比较。性能差异主要来自优化方式不同,传统方法依赖人工设计调度规则,而ForgeStencil利用智能体自动探索内存访问、计算融合和GPU资源利用方式,更适合复杂工业软件优化场景。
如何使用ForgeStencil
- 环境配置:安装NVIDIA GPU环境,准备CUDA 12.x、Python 3.9以上版本和C++17编译器。例如使用A100-SXM4-80GB GPU完成验证,并安装numpy、cupy依赖,可提升运行稳定性。
- 快速运行算子测试:执行
python tools/run.py --stencil star_1 --shape 256 --gpu 0进行单算子测试。该配置可在约1分钟内完成测试,并输出优化算子与基准实现的性能差异。 - 执行应用优化:进入目标应用目录运行vendor.sh获取源码,再执行patch集成。例如使用
python ../../harness/run_e2e.py --app应用名称--gpu auto完成真实应用性能验证。 - 查看测试结果:通过
results/integration_registry.json查看应用优化数据,包括加速比例、验证状态和测试记录,方便研究人员分析优化效果。
ForgeStencil的局限性
- GPU验证范围限制:目前100个端到端应用主要基于A100完成验证,虽然算子级支持A100/H100/B200架构,但部分跨代应用测试仍处于扩展阶段,官方路线图计划继续扩大硬件验证范围。
- 优化收益存在差异:部分高度优化软件可能只能获得1.0-1.5倍提升,例如已接近硬件极限的程序优化空间有限,原因在于原始代码已经充分利用GPU资源,后续需要结合更多架构研究。
- 智能体结果存在随机性:由于系统由大模型驱动,单次优化路径可能不同,但最终生成patch和测试结果可以复现,目前官方计划继续公开智能体成本和迭代指标。
ForgeStencil相关资源
ForgeStencil的典型应用场景
- 油气地震勘探:优化RTM逆时偏移、TOTAL E&P minimod等算法,提高地震成像计算效率,ForgeStencil在RTM场景实现1.81倍加速。
- 电磁仿真:针对gprMax/FDTD等Yee网格Maxwell方程计算进行算子优化,加速雷达、芯片电磁分析等高性能计算任务。
- 医学影像:优化MRI重建、数字乳腺断层成像等计算流程,提升医疗设备中的图像处理效率,降低复杂计算耗时。
- 气候与科学计算:面向气象模拟、流体力学、材料科学等Stencil密集型任务,通过GPU算子优化提升科学计算性能。
- 工业软件优化:针对工业仿真、工程计算、高性能计算软件进行自动优化,帮助已有软件提升GPU运行效率。
ForgeStencil常见问题
ForgeStencil怎么用?
ForgeStencil需要在NVIDIA GPU环境运行,支持CUDA 12.x、Python 3.9+和C++17编译环境。用户可通过GitHub获取代码,运行tools/run.py测试算子性能,也可以复现真实应用优化流程。
ForgeStencil支持哪些GPU?
ForgeStencil目前支持A100、H100和B200架构适配,其中100个端到端应用结果已在A100完成验证。不同GPU会通过运行时架构分派选择对应Kernel路径。
ForgeStencil和Halide哪个好?
两者定位不同,Halide主要用于自动生成优化代码,ForgeStencil侧重智能体自动发现策略并部署到真实应用。测试显示,ForgeStencil算子级相比公开基线几何平均加速约2.16倍。
ForgeStencil免费吗?
ForgeStencil已开源,采用Apache-2.0许可证,用户可以免费获取代码进行研究和开发。实际运行仍需要准备NVIDIA GPU、CUDA环境等计算资源。
ForgeStencil支持哪些应用?
ForgeStencil覆盖油气勘探、电磁仿真、医学影像、气候模拟、材料科学等领域,目前已完成100个真实工业和科学计算软件优化验证。
相关文章


 浙公网安备33010202004812号